 Resposta e assertividade de inteligências artificiais a prompts direcionados ao manejo da lesão por pressão
RESUMO
Objetivo: Comparar as respostas e a assertividade de diferentes Inteligências Artificiais a partir de um conjunto de prompts para o manejo da lesão por pressão.
Método: Estudo descritivo, comparativo, das respostas de Inteligências Artificiais, realizado entre outubro e novembro de 2025, em dois momentos: 1) Estudo de prompts e 2) Teste para obtenção das respostas. Foram avaliadas a Perplexity AI, Grok AI, Blackbox AI, OpenAI ChatGPT-4.0®, Gemini® e Claude AI, divididas aleatoriamente nos grupos hybrid prompting e zero-shot. As respostas foram organizadas em planilha do Excel e analisadas de forma descritiva.
Resultados: A assertividade geral das inteligências artificiais foi 31,9%. O grupo hybrid prompting alcançou 36,1% e o zero-shot obteve 27,7%. A IA Gemini® demonstrou maior assertividade e o ChatGPT-4.0® a pior.Conclusão: A Assertividade apresentada indica que a recomendação mais segura é o modelo hybrid prompt, integrando inteligência artificial ao julgamento clínico humano.
DESCRITORES:
Inteligência Artificial Generativa; Modelos de Linguagem de Grande Escala; Equipe de Enfermagem; Raciocínio Clínico; Úlcera por Pressão
HIGHLIGHTS
1. Comparou-se a assertividade das IA via prompts sobre lesão por pressão.
2. A assertividade das IA foi de 31,9% com 23 acertos.
3. O hybrid prompting apresentou maior assertividade que o zero-shot.
4. Gemini® apresentou maior assertividade para o manejo da lesão por pressão.
ABSTRACT
Objective: To compare the responses and accuracy of different Artificial Intelligences based on a set of prompts for the management of pressure injury.
Method: A descriptive, comparative study of the responses of Artificial Intelligences, carried out between October and November 2025, in two stages: 1) Study of prompts and 2) Test to obtain the responses. The following were evaluated: Perplexity AI, Grok AI, Blackbox AI, OpenAI ChatGPT-4.0®, Gemini®, and Claude AI, randomly divided into the hybrid prompting and zero-shot groups. The responses were organized in an Excel spreadsheet and analyzed descriptively.
Results: The overall accuracy of the artificial intelligences was 31.9%. The hybrid prompting group reached 36.1% and the zero-shot obtained 27.7%. The Gemini® AI demonstrated the highest accuracy and ChatGPT-4.0® the worst.
Conclusion: The accuracy presented indicates that the safest recommendation is the hybrid prompt model, integrating artificial intelligence with human clinical judgment.
DESCRIPTORS:
Generative Artificial Intelligence; Large Language Models; Nursing; Team; Clinical Reasoning; Pressure Ulcer.
HIGHLIGHTS
1. The accuracy of the AIs was compared via prompts on pressure injury.
2. The accuracy of the AIs was 31.9% with 23 correct answers.
3. Hybrid prompting showed higher accuracy than zero-shot.
4. Gemini® showed the highest accuracy for pressure injury management.
RESUMEN
Objetivo: Comparar las respuestas y la precisión de diferentes Inteligencias Artificiales a partir de un conjunto de prompts para el manejo de la lesión por presión.
Método: Estudio descriptivo, comparativo, de las respuestas de Inteligencias Artificiales, realizado entre octubre y noviembre de 2025, en dos momentos: 1) Estudio de prompts y 2) Prueba para la obtención de las respuestas. Se evaluaron Perplexity AI, Grok AI, Blackbox AI, OpenAI ChatGPT-4.0®, Gemini® y Claude AI, divididas aleatoriamente en los grupos hybrid prompting y zero-shot. Las respuestas se organizaron en una planilla de Excel y se analizaron de forma descriptiva.
Resultados: La precisión general de las inteligencias artificiales fue del 31,9%. El grupo hybrid prompting alcanzó el 36,1% y el zero-shot obtuvo el 27,7%. La IA Gemini® demostró la mayor precisión y el ChatGPT-4.0®, la peor.
Conclusión: La precisión presentada indica que la recomendación más segura es el modelo hybrid prompting, integrando la inteligencia artificial en el juicio clínico humano.
DESCRIPTORES:
Inteligencia Artificial Generativa; Grandes Modelos de Lenguaje; Grupo de Enfermería; Razonamiento Clínico; Úlcera por Presión.
HIGHLIGHTS
1. Se comparó la precisión de las IA mediante prompts sobre lesión por presión.
2. La precisión de las IA fue del 31,9% con 23 aciertos.
3. El hybrid prompting presentó mayor precisión que el zero-shot.
4. Gemini® presentó mayor precisión para el manejo de la lesión por presión.
INTRODUÇÃO
As lesões por pressão (LP) constituem uma complicação frequente e global, com prevalência que pode alcançar 72,5%, variando conforme o contexto1. Desde 2013, o programa Patients for Patient Safety inclui a redução das LP como sua sexta meta, reforçando a importância de medidas que qualifiquem a assistência e promovam a segurança do paciente2.
A National Pressure Injury Advisory Panel (NPIAP) define a LP como um dano localizado na pele ou tecido subjacente, geralmente sobre proeminências ósseas ou áreas submetidas à pressão, cisalhamento ou fatores químicos, físicos e biológicos3. São classificadas em estágios que variam de um (eritema não branqueável) a quatro (perda total de espessura com exposição de estruturas profundas), além da lesão não classificável, tissular profunda, relacionada a dispositivos médicos e em mucosas4.
O surgimento de LP em pacientes institucionalizados tem sido associado a falhas assistenciais, como reposicionamento inadequado, ausência de exame físico, déficit de recursos humanos e materiais, além de insuficiente domínio sobre coberturas, curativos e novas tecnologias2. A atualização científica, associada à habilidade técnica do enfermeiro, é fundamental para a escolha adequada da cobertura, contribuindo para a qualidade do cuidado e prevenção de complicações3.
A tecnologia em saúde tem se expandido nas últimas décadas, destacando-se a Inteligência Artificial (IA), capaz de processar grandes volumes de dados rapidamente e apoiar decisões personalizadas5. A crescente integração da IA aos serviços de saúde indica tendência de uso ampliado, tornando essencial reconhecer seu potencial para aprimorar conhecimentos e práticas. Nesse cenário de transformação acelerada, discutir vantagens e limitações desses modelos fortalece uma postura crítica frente ao uso da IA no cuidado em saúde6.
Na saúde, a IA tem sido introduzida majoritariamente como uma ferramenta de suporte à tomada de decisão clínica em situações complexas, tais como a identificação de fatores de risco, definição de prognóstico e a precisão diagnóstica de LP7. Um estudo alemão apontou a utilização da IA por enfermeiros para reconhecimento, classificação, redução, previsão e estratificação de risco de LP, destacando o alto grau de especificidade8, evidenciando que a IA não apenas complementa práticas clínicas rotineiras, mas também demonstra sua aplicabilidade em cenários complexos da saúde.
São descritos dois modelos principais de IA: a preditiva, voltada à previsão de desfechos a partir de algoritmos alimentados por grande volume de dados; e a generativa, que articula os algoritmos capazes de criar conteúdos, incluindo textos, imagens, áudio, entre outros9. Os Large Language Models (LLM), ou Modelos de Linguagem de Grande Escala, são sistemas de IA treinados com grandes volumes de dados para reconhecer padrões e gerar respostas em linguagem natural. Os LLM, quando otimizados por meio de abordagens estruturadas, como a integração com bases de conhecimento e diretrizes clínicas, podem apresentar desempenho superior e alinhamento às diretrizes e recomendações, inclusive no contexto da enfermagem10-11. Os chatbots (espaço de interação) alimentados pela IA generativa consolidam-se como um recurso de apoio, oferecendo respostas personalizadas aos usuários6.
A IA pode elaborar recomendações e condutas personalizadas considerando o cenário terapêutico do paciente, contudo são respostas dadas a partir de comandos chamados prompts e algoritmos sofisticados. Possibilita, ainda, identificar padrões clínicos ao analisar extensos conjuntos de dados9, fornecendo informações em tempo real. Entretanto, destaca-se que mesmo os modelos mais aprimorados podem não captar toda a complexidade da expertise clínica dos profissionais no manejo das lesões por pressão ou feridas crônicas10-11.
A integração dessa tecnologia na prática de enfermagem demanda uma abordagem cautelosa e consciente pelo profissional, sendo essencial que seu uso reflita seus potenciais benefícios, limitações e riscos para a segurança do paciente6. Entretanto, o uso da IA deve ser compreendido como uma ferramenta de apoio, e não como substituto do julgamento clínico e da tomada de decisão profissional, devendo ser utilizada para potencializar o cuidado5,10-11.
Nesse sentido, a literatura traz a necessidade de treinar a IA com um grande volume de dados como os LLM, contudo na prática assistencial o profissional utiliza a ferramenta mais acessível, sem a inserção de dados estruturados. Dessa forma, existe uma lacuna de conhecimento, que precisa ser preenchida, para entender como essas IA se comportam sem que isso seja feito previamente. O uso da IA no cotidiano da prática, portanto, deve estar aliado ao rigor metodológico, ao uso de dados fidedignos e ao prompt solicitado, garantindo sua confiabilidade e utilização como recurso facilitador no manejo das LP, auxiliando na escolha da cobertura mais adequada e contribuindo para a integridade da pele do paciente.
Destarte, o objetivo deste estudo é comparar as respostas e a assertividade de diferentes Inteligências Artificiais a partir de um conjunto de prompts para o manejo da lesão por pressão.
MÉTODO
Estudo descritivo e comparativo, das respostas de Inteligências Artificiais a partir de um conjunto de prompts, realizado entre outubro e novembro de 2025, em dois momentos: 1) Estudo de prompts e 2) Teste para obtenção das respostas das IA.
Foram utilizadas as seguintes IA: Perplexity AI, Grok AI, Blackbox AI, OpenAI ChatGPT-4.0®, Gemini® e Claude AI. As IA foram selecionadas por apresentarem plataformas cujos termos de uso permitem o envio e a análise de imagens de LP, além de sua indexação gratuita. As IA Microsoft Copilot, DeepSeek e Meta AI foram excluídas por não fazerem a leitura de imagens conforme os termos de uso.
Optou-se pela divisão das IA de forma aleatória em dois grupos: o modelo hybrid prompting, articulando diferentes técnicas (few-shot, role-prompting, chain-of-thought e chain-of-verification), e o modelo zero-shot da engenharia de prompts12. De acordo com a Pan American Health Organization, o termo prompt refere-se às instruções fornecidas a um sistema de IA, com pergunta breve ou solicitação detalhada, que especifica o tom, contexto, formato e o objetivo desejado, cuja clareza e fundamentação contextual influenciam diretamente a qualidade da resposta gerada13.
Optou-se pelas técnicas hybrid prompting e zero-shot, buscando atender de forma detalhada e contextualizada a resposta da IA frente às necessidades de decisão do enfermeiro para o manejo da LP e, com base em suas potencialidades, para alcançar a precisão e confiabilidade nas respostas14.
A técnica hybrid prompting integra diferentes técnicas de prompt, combinando pontos fortes para aprimorar o desempenho com respostas mais precisas e alinhadas aos objetivos, que demanda instruções mais complexas15. A combinação ocorre por meio do few-shot, que fornece exemplos para orientar padrões de resposta14; do role prompting, que atribui um papel específico ao modelo; do chain-of-thought, que o leva a explicitar o raciocínio passo a passo14; e do chain-of-verification, estruturado em quatro etapas: resposta base, plano de verificação, checagens e resposta final, aumentando rigor e confiabilidade16. Já a estratégia zero-shot consiste em obter uma resposta a partir de um único comando inicial, sem oferecer exemplos ou informações adicionais prévias14.
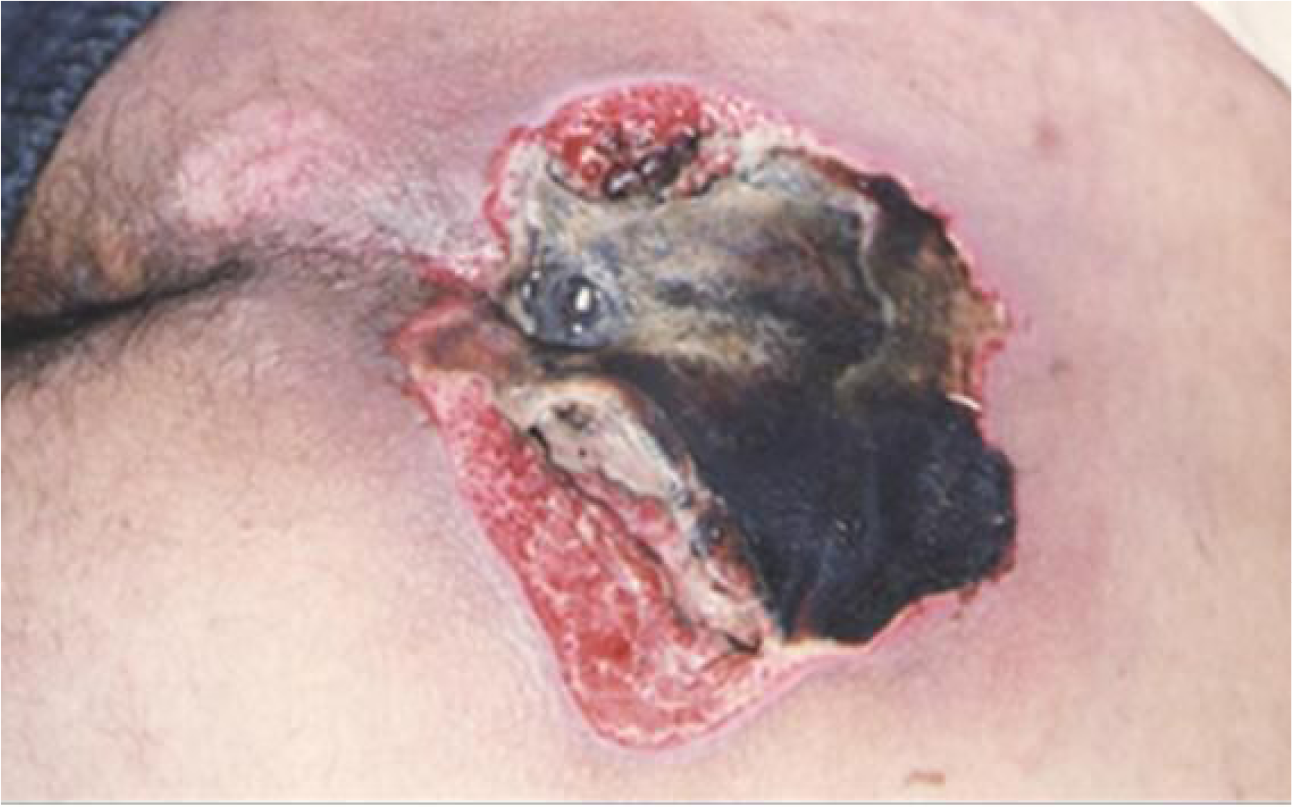
Para a coleta de dados, que ocorreu em dois dias no mês de novembro de 2025, cada modelo foi alimentado com uma imagem previamente selecionada pela equipe, correspondente a uma LP não classificável segundo o consenso NPIAP (Figura 1), inserida diretamente nas IA utilizando contas (e-mail e login) criadas exclusivamente para o estudo, para minimizar vieses decorrentes de prompts anteriores no perfil individual de usuário. As respostas geradas foram registradas no perfil do projeto e salvas como arquivo digital por meio de capturas de tela.

Imagem de lesão por pressão não classificável selecionada pela equipe do estudo. Rio das Ostras, RJ, Brasil, 2025 Fonte: Feridas Crônicas - Recurso Educacional sobre Prevenção e Manejo da Lesão por Pressão (2020)17.
A LP não classificável caracteriza-se por perda da pele em sua espessura total, cuja real profundidade e extensão não podem ser mensuradas devido à cobertura por tecido necrótico ou desvitalizado. Somente após sua remoção torna-se possível a avaliação completa, geralmente evidenciando uma LP estágio 3 ou 418-19.
A aleatorização por meio de sorteio ocorreu antes da alimentação da IA com a imagem, em processo no qual um membro da equipe de pesquisa escreveu em papéis os nomes das IA e os colocou em uma caixa. Iniciou-se o sorteio pelo grupo de hybrid prompting e após o primeiro, alternaram-se os grupos até finalizar o sorteio.
O grupo que recebeu o prompt zero-shot foi composto pela Perplexity AI, Grok AI e Blackbox AI, que receberam a seguinte instrução: “Responda o instrumento a seguir com base na imagem”. O referido instrumento foi desenvolvido para este estudo e é constituído por 12 itens redigidos no formato de afirmações (Figura 2). Os tipos de cobertura listados no check-list foram definidos com base nas opções mais frequentes utilizadas por enfermeiros, segundo a literatura18-20.

Instrumento elaborado para grupo de IA com prompt zero-shot. Rio das Ostras, RJ, Brasil, 2025 Fonte: Os autores (2025).
O grupo composto pelas IA OpenAI ChatGPT-4.0®, Gemini® e Claude AI recebeu a técnica de hybrid prompting, com o prompt criado para este estudo: “Você é um enfermeiro especialista em curativos com experiência em avaliação, classificação e manejo de lesões por pressão. Seu público-alvo é um paciente que apresenta uma lesão tegumentar. Seu objetivo, a partir da imagem anexada, é classificar a lesão por pressão, identificar estruturas acometidas e tecidos presentes, identificar se há presença de exsudato, indicar como realizar a limpeza dessa lesão, indicar a cobertura primária e secundária e recomendar a frequência da troca de curativos. O formato da resposta deve ser em texto estruturado, com tom informativo, profissional e conciso. Se a imagem for insuficiente para uma decisão segura, informe explicitamente as limitações e descreva quais dados clínicos adicionais são necessários (ex.: sinais vitais, comorbidades, sinais de infecção e exsudato). Sempre use linguagem do tipo “sugestão” quando houver incerteza e evite afirmar diagnóstico médico definitivo. Para chegar à conclusão exponha passo a passo do raciocínio e liste as checagens realizadas (no mínimo 3), por exemplo: correspondência com critérios de classificação, verificação de sinais de infecção, compatibilidade do curativo com o exsudato, e verificação de riscos de maceração ou trauma.”
As respostas esperadas, considerando ambos os prompts, foram definidas com base na literatura atualizada18-19,21-22 sobre o tema e estão dispostas no Quadro 1.
As respostas coletadas de cada IA foram inseridas em planilha do Microsoft Excel® e analisadas de forma descritiva, sendo dicotomizadas entre “corretas” e “incorretas”. Foram calculados: 1) percentual de acertos em relação a cada item do instrumento; 2) percentual de acertos total e 3) o percentual de acertos por grupo de IA. Destaca-se que os itens 1, 4 e 12 possuem apenas uma alternativa correta. Em cada questão, foram consideradas “Corretas” apenas as alternativas que correspondem integralmente às afirmações esperadas; todas as demais foram classificadas como “Incorretas”. As respostas apresentadas com a opção “Talvez” também foram categorizadas como “Incorretas”.
Para o universo de acertos considerou-se os 12 itens do instrumento e as seis IA analisadas, totalizando 72 acertos possíveis. Para a assertividade geral das IA, somou-se o total de acertos e dividiu-se pelo universo de acertos possíveis. Para o cálculo da assertividade geral dos itens, somaram-se os acertos do item e dividiu-se pelo universo de acertos possíveis no item, considerando o quantitativo das IA, esse número foi de seis. No cálculo da assertividade por grupos, somou-se o total de acertos em cada grupo e dividiu-se pelo universo de acertos possíveis, sendo 36 em cada. Para calcular qual IA foi mais assertiva, utilizou-se o total de acertos apresentados dividido pelo total de itens do instrumento.
Dispensou-se a submissão do estudo ao Comitê de Ética em Pesquisa, uma vez que a pesquisa não envolveu seres humanos, conforme a Lei nº 14.874/2024.
RESULTADOS
A assertividade geral das IA analisadas foi de 31,9% com 23 acertos. No entanto, a porcentagem do grupo hybrid prompting foi de 36,1% com 13 acertos e 23 erros no total, demonstrando assertividade ligeiramente superior ao grupo zero-shot que foi de 27,7% com 10 acertos e 26 erros no total (Tabela 1).
Porcentagem de acertos conforme instrumento dos seis modelos de IA. Rio das Ostras, RJ, Brasil, 2025
Entre os itens analisados, apenas dois apresentaram acerto de 100%: o item 7, referente à higienização da lesão, e o item 10, relativo ao desbridamento, indicando consenso entre todas as IA nesses aspectos. Em contraste, itens fundamentais para a avaliação da lesão não registraram acerto, como o item 2 (estruturas acometidas), o item 5 (borda da lesão) e o item 11 (cobertura secundária), evidenciando a incapacidade dos modelos de identificar elementos essenciais ao manejo da LP. Nos demais itens, observou-se variabilidade entre os dois tipos de prompts, com diferenças pontuais de desempenho.
Entre as IA analisadas, a Gemini® apresentou a maior assertividade com seis (50,0%) acertos, seguida da Claude AI com cinco (41,6%) acertos, Perplexity IA com quatro acertos (33,3%) e as Grok AI e Blackbox AI com três (25,0%) cada. A pior assertividade foi apresentada pelo ChatGPT-4.0® com dois (16,6%) acertos. Os resultados demonstraram heterogeneidade nas respostas.
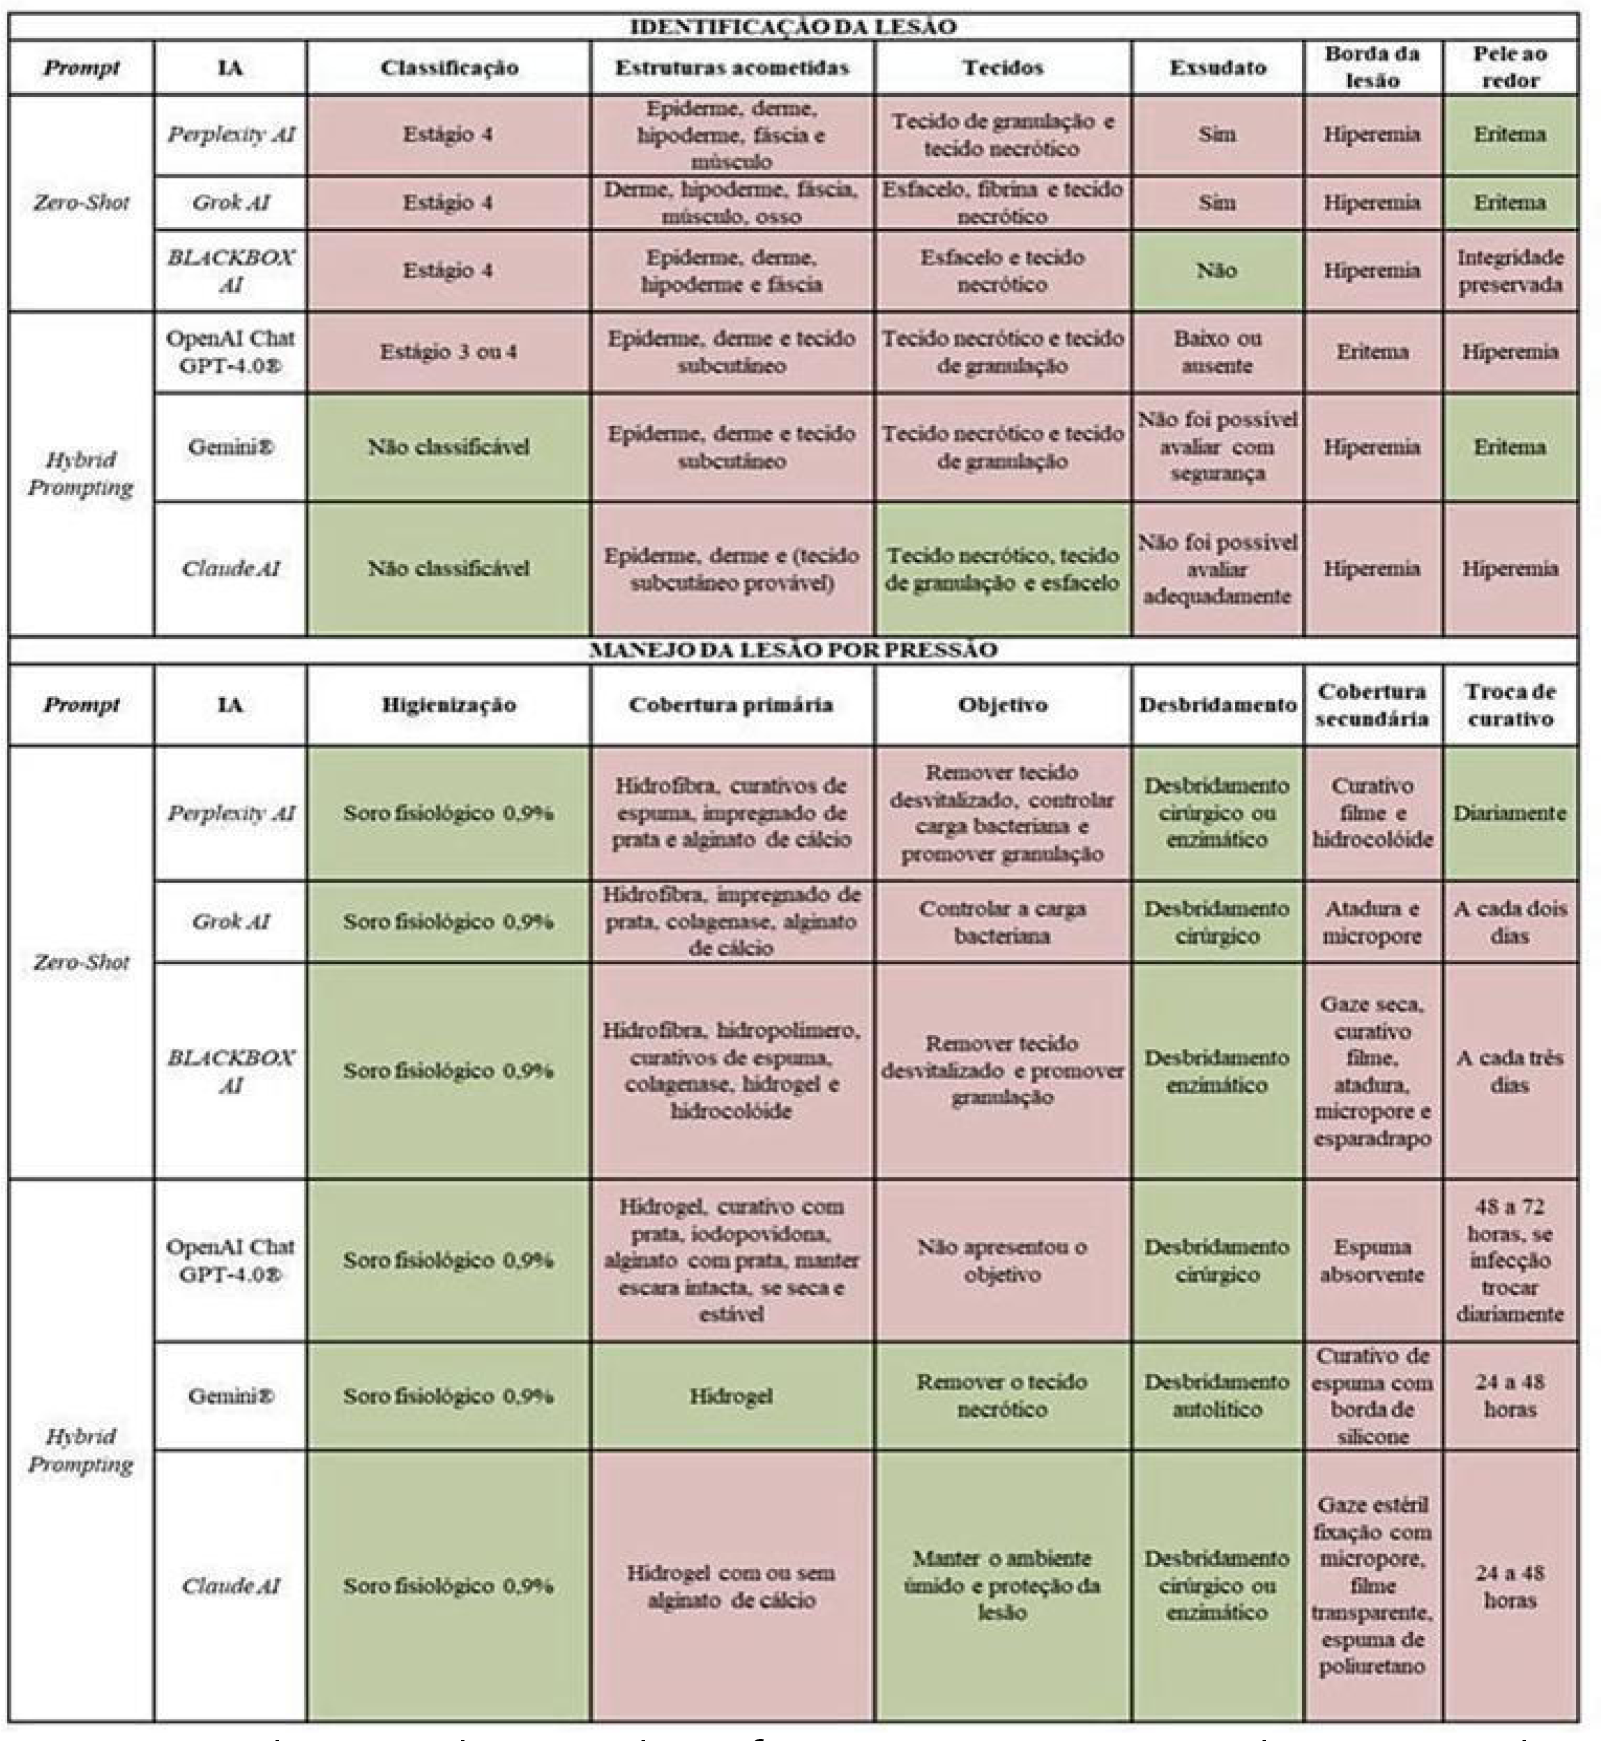
O grupo de hybrid prompting apresentou maior assertividade na identificação e manejo da LP (Figura 3). Quanto à identificação da LP, o grupo zero-shot não apresentou acertos referentes à classificação, às estruturas acometidas e à borda da lesão. A Blackbox AI apresentou resposta correta quanto à ausência de exsudato, e as Perplexity AI e Grok AI no reconhecimento do eritema na pele ao redor. Já o grupo hybrid prompting não foi assertivo nas respostas referentes a estruturas acometidas, exsudato e borda da lesão. Tanto a Gemini® quanto a Claude AI acertaram a classificação da LP, sendo que a Gemini® também localizou o eritema na pele ao redor e a Claude AI descreveu corretamente os tecidos presentes na imagem.
Respostas da IA sobre a identificação e o manejo da LP. Rio das Ostras, RJ, Brasil, 2025 Legenda: cor vermelha - erro na resposta; cor verde - acerto na resposta. Fonte: Os autores (2025).
Quanto ao manejo da LP, a higienização com soro fisiológico 0,9% e a necessidade de desbridamento foram unanimemente indicadas entre as seis IA. O grupo zero-shot não foi assertivo nos itens referentes à cobertura primária, ao objetivo do curativo e à cobertura secundária. No item troca de curativo, somente a Perplexity AI respondeu que a troca deveria ocorrer diariamente. No grupo hybrid prompting os itens de cobertura secundária e troca de curativo não foram respondidos corretamente por nenhuma das três IA. A Gemini® destacou-se por acertar ainda os itens de cobertura primária e objetivo e a Claude AI no objetivo.
DISCUSSÃO
Os achados deste estudo evidenciam que, embora as IA avaliadas tenham reconhecido condutas fundamentais e consensuais no manejo de LP, como a higienização com soro fisiológico e a indicação de desbridamento, a assertividade geral pode ser considerada baixa, uma vez que não atingiu sequer metade dos acertos possíveis. Apesar do desempenho satisfatório dessas ferramentas em tarefas de menor complexidade, verificaram-se limitações importantes, incluindo inconsistências nas interpretações e a possibilidade de ocorrência de alucinações, o que compromete a confiabilidade das respostas geradas7.
O hybrid prompting apresentou assertividade discretamente superior quando comparado ao zero-shot, incluindo maior cautela nas respostas. No item referente ao exsudato, por exemplo, dois modelos reconheceram as limitações da imagem e apresentaram suas respostas em tom sugestivo quando não havia elementos suficientes para afirmações definitivas. A literatura reforça que não se deve restringir a análise a um único tipo de prompt, visto que prompts elaborados e estruturados tendem a favorecer respostas refinadas e análises mais completas23.
A engenharia de prompt pode aumentar a assertividade em sistemas de IA aplicados à saúde, conforme demonstrou um estudo europeu que observou um incremento de 80,1% para 99,6%, na comparação entre consultas realizadas com comandos simples e comandos mais elaborados, entretanto, esse ganho foi acompanhado de maior tempo de resposta e impacto na satisfação do usuário24. Reforça-se que, no contexto clínico, é necessário validar também outros critérios, como rapidez do sistema, transparência com a IA e usabilidade da técnica de prompting25. Assim, tornam-se essenciais estudos de validação e avaliação que verifiquem se a IA apresenta desempenho adequado para síntese de evidências e contribui de maneira segura para a prática profissional26.
Existe uma lacuna na literatura, especialmente no que se refere a escassez de referências que abordem, de forma aprofundada e sistematizada, as técnicas de prompting aplicadas ao manejo de LP. Tal lacuna restringe comparações com a literatura e evidencia um campo ainda em desenvolvimento. Contudo, outros campos clínicos têm sido abordados internacionalmente, como um estudo desenvolvido na Suécia para avaliação de desempenho de LLM na identificação de erros de medicação, demonstrando que mecanismos de checagem interna (critic model) aumentam a confiabilidade da resposta da IA27 e, um estudo coreano que comparou diferentes estratégias de engenharia de prompts, identificando o método Chain-of-Thought com respostas mais consistentes no contexto terapêutico da enfermagem psiquiátrica28.
Em relação às indicações de coberturas primárias, as IA apresentaram distintas possibilidades. Embora alginato de cálcio, espumas e curativos com prata sejam compatíveis com feridas em que há perda de espessura total, tais opções não correspondiam à lesão analisada20. Embora o instrumento de referência não incluísse a hidrofibra como cobertura primária, os modelos de IA a citaram com frequência. A literatura internacional reconhece essa opção como adequada por favorecer o desbridamento autolítico, indicado para remover tecido desvitalizado29, compatível com o esfacelo em pequena quantidade observado na imagem.
As IA têm potencial para apoiar profissionais de saúde, aumentando a eficiência clínica e a segurança do paciente1. Porém, competências humanas como raciocínio clínico, tomada de decisão e interpretação permanecem insubstituíveis. Assim, recomendações das IA devem ser avaliadas pelo profissional antes de serem aplicadas7. Embora seja pertinente problematizar as possíveis causas do elevado número de erros de determinadas IA, como o ChatGPT-4.0®, não é possível, a partir dos dados deste estudo, inferir com precisão os fatores determinantes dessas falhas. Portanto, o uso de IA no manejo de LP deve ser entendido como ferramenta complementar, preservando a autonomia do enfermeiro nas decisões.
Cabe destacar que existe a necessidade premente de incorporar o letramento em inteligência artificial na formação e na educação permanente de profissionais da saúde, conforme destaca uma revisão sistemática que investigou o nível de letramento em IA entre profissionais de saúde e estudantes, em que metade dos estudos incluídos encontrou muito baixo letramento entre ambos30. Nesse sentido, não basta apenas utilizar a IA, mas desenvolver competências para formular perguntas claras, contextualizadas e clinicamente relevantes, além de interpretar e validar os resultados gerados. A ausência desse domínio pode levar a respostas imprecisas, equivocadas ou potencialmente inseguras, mesmo quando se utilizam modelos aparentemente confiáveis. Assim, o letramento em IA emerge como um componente essencial para o uso seguro, ético e efetivo dessas tecnologias no manejo de lesões por pressão e em outros contextos assistenciais.
Este estudo apresenta limitações em relação à realização única de cada consulta à IA que limita a avaliação da variabilidade das respostas, uma vez que modelos generativos podem produzir resultados distintos a cada interação. Ademais, a análise foi conduzida sobre um número restrito de modelos de IA e versões específicas disponíveis no período da pesquisa, o que pode não refletir o desempenho de ferramentas pagas ou de outras plataformas.
Este estudo não avaliou a concordância interavaliadores, a consistência dos modelos ou o tempo de resposta de cada IA. Dessa forma, a taxa de assertividade em cada IA pode ser influenciada por diferentes interpretações dos especialistas e profissionais de saúde acerca do que seria considerado uma resposta correta, o que introduz variabilidade na avaliação e se apresenta como outra limitação do estudo. Ademais, não foi mensurada a consistência das respostas dos modelos, considerando que uma IA pode parecer confiável e produzir respostas estáveis e, ainda assim, apresentar erros sistemáticos sob a perspectiva clínica, o que representa risco em contextos assistenciais. O estudo não considerou ainda, o tempo de resposta dos modelos, aspecto relevante para a aplicabilidade clínica, uma vez que modelos mais ágeis, ainda que menos precisos, podem ser mais viáveis e apresentar melhor usabilidade no fluxo de trabalho.
Dessa forma, esses são pontos que direcionam para estudos futuros que ampliem a noção de segurança para além da assertividade, incorporando também dimensões como consistência, usabilidade e eficiência no contexto real de cuidado. Recomenda-se, portanto, que, na avaliação da aplicação de modelos de IA na saúde, sejam realizadas análises conjuntas de acurácia e consistência, especialmente no contexto multimodal do manejo de lesões por pressão, no qual a complexidade interpretativa é elevada.
CONCLUSÃO
A assertividade das IA relacionadas ao manejo da LP, de 31,9% foi considerada baixa, contudo, a IA Gemini® demonstrou maior assertividade e o ChatGPT-4.0®, a pior. Embora as inteligências artificiais não tenham sido originalmente desenvolvidas para a área da saúde, a assertividade apresentada indica que a recomendação mais segura é o modelo hybrid prompting, integrando inteligência artificial ao julgamento clínico humano.
Ao evidenciar tanto potencialidades quanto limitações relevantes, torna-se claro que a IA deve ser compreendida como ferramenta complementar na prática de enfermagem, demandando responsabilidade e uso consciente para assegurar que sua aplicação fortaleça o cuidado, sem comprometer a segurança do paciente e preservando o papel central do profissional de saúde na tomada de decisões quanto ao manejo das lesões.
Em um cenário marcado pela crescente utilização desses modelos, é fundamental ampliar o debate sobre a integração responsável da IA no cuidado e sinalizar a necessidade de que futuras investigações avancem no desenvolvimento de metodologias mais robustas. Nesse sentido, torna-se essencial explorar estratégias de prompting em diferentes contextos assistenciais, contribuindo para o aprimoramento científico e ético do uso dessas tecnologias na enfermagem. Tal abordagem pode evitar a adoção indiscriminada de ferramentas, cuja aplicabilidade em saúde ainda demanda mais investigação e validação.
COMO REFERENCIAR ESTE ARTIGO:
Disponibilidade de dados:
Os autores declaram que os dados estão disponíveis de forma completa no corpo do artigo.
REFERÊNCIAS
-
1 Pott FS, Meier MJ, Stocco JGD, Petz FFC, Roehrs H, Ziegelmann PK. Pressure injury prevention measures: overview of systematic reviews. Rev Esc Enferm USP [Internet]. 2023 [cited 2025 Aug 15];57:e20230039. Available from: https://doi.org/10.1590/1980-220X-REEUSP-2023-0039en
» https://doi.org/10.1590/1980-220X-REEUSP-2023-0039en -
2 Fontes TLA, de Oliveira BGRB, De Oliveira MF, da Silva MA, da Silva ARG, Pires BMFB, et al. Development of a checklist to prevent pressure injuries in patients with COVID-19. Rev enferm UFPE on line [Internet]. 2024 [cited 2025 Aug 15];18(1):e257602. Available from: https://doi.org/10.5205/1981-8963.2024.257602
» https://doi.org/10.5205/1981-8963.2024.257602 -
3 Macêdo SM, Bastos LLAG, Oliveira RGC, Lima MCV, Gomes FCF. Selection criteria for primary dressings in the treatment of pressure ulcers in hospitalized patients. Cogitare Enferm [Internet]. 2021 [cited 2025 Aug 25];26:e74400. Available from: http://dx.doi.org/10.5380/ce.v26i0.74400
» http://dx.doi.org/10.5380/ce.v26i0.74400 -
4 de Araújo CAF, Pereira SRM, de Paula VG, de Oliveira JA, de Andrade KBS, de Oliveira NVD. Evaluation of the knowledge of nursing professionals in the prevention of pressure ulcer in intensive care. Esc Anna Nery [Internet]. 2022 [cited 2025 Aug 25];26:e20210200. Available from: https://doi.org/10.1590/2177-9465-EAN-2021-0200
» https://doi.org/10.1590/2177-9465-EAN-2021-0200 -
5 Kotp MH, Ismail HA, Basyouny HAA, Aly MA, Hendy A, Nashwan AJ, et al. Empowering nurse leaders: readiness for AI integration and the perceived benefits of predictive analytics. BMC Nursing [Internet]. 2025 [cited 2025 Aug 25];24(56):1-13. Available from: https://doi.org/10.1186/s12912-024-02653-x
» https://doi.org/10.1186/s12912-024-02653-x -
6 Dal Sasso GTM, Lanzoni GMM, Alvarez AG, Barra DCC, Barbosa SFF. Potential contribution of Chatgpt® to learning about septic shock in intensive care. Texto Contexto Enferm [Internet]. 2024 [cited 2025 Aug 25];33:e20230184. Available from: https://doi.org/10.1590/1980-265X-TCE-2023-0184en
» https://doi.org/10.1590/1980-265X-TCE-2023-0184en -
7 Vitorino LM, Yoshinari Junior GH, Lopes-Júnior LC. Artificial intelligence in nursing: advancing clinical judgment and decision-making. Rev Bras Enferm [Internet]. 2025 [cited 2025 Nov 19];78(4):e780401. Available from: https://doi.org/10.1590/0034-7167.2025780401
» https://doi.org/10.1590/0034-7167.2025780401 -
8 Seibert K, Domhoff D, Bruch D, Schulte-Althoff M, Fürstenau D, Biessmann F, et al. Application scenarios for artificial intelligence in nursing care: rapid review. J Med Internet Res [Internet]. 2021 [cited 2025 Aug 22];23(11):e26522. Available from: https://www.jmir.org/2021/11/e26522
» https://www.jmir.org/2021/11/e26522 -
9 Sampaio RC, Sabbatini M, Limongi R. Diretrizes para o uso ético e responsável da Inteligência Artificial Generativa: um guia prático para pesquisadores. São Paulo: Editora Intercom [Internet]. 2024 [cited 2025 Aug 20]. 62 p. Available from: https://prpg.unicamp.br/noticias/lancamento-diretrizes-para-o-uso-etico-e-responsavel-da-inteligencia-artificial-generativa-um-guia-pratico-para-pesquisadores/
» https://prpg.unicamp.br/noticias/lancamento-diretrizes-para-o-uso-etico-e-responsavel-da-inteligencia-artificial-generativa-um-guia-pratico-para-pesquisadores/ -
10 Shi J, Chen H, Shi C, Su C, Yue S, Li W, et al. Development and comparative evaluation of knowledge graph-enhanced large language models for domain-specific question answering in nursing. BMC Nursing [Internet]. 2026 [cited 2026 May 5];25:530. Available from: https://doi.org/10.1186/s12912-026-04647-3
» https://doi.org/10.1186/s12912-026-04647-3 -
11 Gurler N, Sengul T, Bulbul SH, Akyaz DY, Guler O, Yantac AE, et al. Secure and accessible AI in nursing education: a modular agentic chatbot framework comparing ChatGPT-4o with an open-source LLM for chronic wound care. Nurse Educ Pract [Internet]. 2026 [cited 2026 May 5];93:104789. Available from: https://doi.org/10.1016/j.nepr.2026.104789
» https://doi.org/10.1016/j.nepr.2026.104789 -
12 Bsharat SM, Myrzakhan A, Shen Z. Principled instructions are all you need for questioning LLaMA-1/2, GPT-3.5/4. arXiv [Internet]. 2024 [cited 2025 Sep 19];2:1-26. Available from: https://arxiv.org/html/2312.16171v2
» https://arxiv.org/html/2312.16171v2 -
13 Pan American Health Organization (PAHO). AI Prompt design for public health: using generative AI responsibly [Internet]. OPAS; 2025. [cited 2025 Sep 30]. 61 p. Available from: https://iris.paho.org/items/b98d9c0f-6008-4b78-9066-01e1e81c29c5
» https://iris.paho.org/items/b98d9c0f-6008-4b78-9066-01e1e81c29c5 -
14 Schulhouff S, Llie M, Balepur N, Kahadze K, Liu A, Si C, et al. The prompt report: a systematic survey of prompt engineering techniques. arXiv [Internet]. 2024 [cited 2025 Sep 30];6:1-80. Available from: https://arxiv.org/abs/2406.06608
» https://arxiv.org/abs/2406.06608 -
15 Vilakati, S. Prompt engineering for accurate statistical reasoning with large language models in medical research. Front Artif Intell [Internet]. 2025 [cited 2025 Nov 18];8:1658316. Available from: https://doi.org/10.3389/frai.2025.1658316
» https://doi.org/10.3389/frai.2025.1658316 -
16 Dhuliawala S, Komeili M, Xu J, Raileanu R, Li X, Celikyilmaz, et al. Chain-of-verification reduces hallucination in large language models. arXiv [Internet]. 2023 [cited 2025 Oct 12];2:1-19. Available from: https://arxiv.org/abs/2309.11495
» https://arxiv.org/abs/2309.11495 -
17 Bernardes, RM. Prevenção e manejo da lesão por pressão: segurança do paciente [Internet]. São Paulo: Universidade de São Paulo; 2020 [cited 2025 Sep 15]. Available from: http://eerp.usp.br/feridascronicas/recurso_educacional_lp_1_4.html
» http://eerp.usp.br/feridascronicas/recurso_educacional_lp_1_4.html -
18 National Pressure Injury Advisory Panel (NPIAP). Prevention and treatment of pressure ulcers/injuries: the international guideline [Internet]. Washington; 2019 [cited 2025 Aug 15]. 405 p. Available from: https://static1.squarespace.com/static/6479484083027f25a6246fcb/t/6553d3440e18d57a550c4e7e/1699992399539/CPG2019edition-digital-Nov2023version.pdf
» https://static1.squarespace.com/static/6479484083027f25a6246fcb/t/6553d3440e18d57a550c4e7e/1699992399539/CPG2019edition-digital-Nov2023version.pdf - 19 Potter PA, Perry AG, Stockert PS. Fundamentos de enfermagem. 11th. Rio de Janeiro: Guanabara Koogan; 2024. 1644 p.
-
20 Zhang C, Zhang S, Wu B, Zou K, Chen H. Efficacy of different types of dressings on pressure injuries: systematic review and network meta-analysis. Nurs Open [Internet]. 2023 [cited 2025 Aug 10];10(9):5857-67. Available from: https://doi.org/10.1002/nop2.1867
» https://doi.org/10.1002/nop2.1867 -
21 Holman, M. Using tap water compared with normal saline for cleansing wounds in adults: a literature review of the evidence. J Wound Care [Internet]. 2023 [cited 2025 Oct 10];32(8):507-12. Available from: https://doi.org/10.12968/jowc.2023.32.8.507
» https://doi.org/10.12968/jowc.2023.32.8.507 -
22 dos Santos TO, da Silva JVL, Rocha RG, Assad LG, da Costa CCP, Pires BMFB. Papain with urea cream in pressure injuries: a case series study. Rev Enferm Atenção Saúde [Internet]. 2024 [cited 2025 Oct 10];13(1):e202404. Available from: https://seer.uftm.edu.br/revistaeletronica/index.php/enfer/article/view/6950
» https://seer.uftm.edu.br/revistaeletronica/index.php/enfer/article/view/6950 -
23 O’Connor S, Peltonen LM, Topaz M, Chen LYA, Michalowski M, Ronquillo C, et al. Prompt engineering when using generative AI in nursing education. Nurse Educ Pract [Internet]. 2024 [cited 2025 Nov 19];74:103825. Available from: https://doi.org/10.1016/j.nepr.2023.103825
» https://doi.org/10.1016/j.nepr.2023.103825 -
24 Wang MH, Jiang X, Zeng P, Li X, Chong KKL, Hou G, et al. Balancing accuracy and user satisfaction: the role of prompt engineering in AI-driven healthcare solutions. Front Artif Intell [Internet]. 2025 [cited 2025 Oct 19];8:1517918. Available from: https://doi.org/10.3389/frai.2025.1517918
» https://doi.org/10.3389/frai.2025.1517918 -
25 Wang M, Cui J, Lee SMY, Lin Z, Zeng P, Li X, et al. Applied machine learning in intelligent systems: knowledge graph-enhanced ophthalmic contrastive learning with “clinical profile” prompts. Front Artif Intell [Internet]. 2025 [cited 2025 Oct 19];8:1527010. Available from: https://doi.org/10.3389/frai.2025.1527010
» https://doi.org/10.3389/frai.2025.1527010 -
26 Flemyng E, Noel-Storr A, Macura B, Gartlehner G, Thomas J, Meerpohl JJ, et al. Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI, and the collaboration for environmental evidence 2025. JBI Evid Synth [Intermet]. 2025 [cited 2025 Oct 10];23(11):2162-6. Available from: https://doi.org/10.11124/JBIES-25-00480
» https://doi.org/10.11124/JBIES-25-00480 -
27 Krifors A, Beskow T, Jonsson M, Lindner KJ, Calås J, Arwsbo V, et al. Improving medication error classification using a reasoning large language model. JAMIA Open [Internet]. 2026 [cited 2025 May 5];9(1):ooag004. Available from: https://doi.org/10.1093/jamiaopen/ooag004
» https://doi.org/10.1093/jamiaopen/ooag004 -
28 Kim SK, Kim GM, Cha S, Jung M. Verification of the validity and reliability of therapeutic communication responses generated by large language models (LLMs): a comparative study of prompt-engineering strategies. J Korean Acad Psychiatr Ment Health Nurs [Internet]. 2025 [cited 2025 May 5];34(Spec):23-35. Available from: https://doi.org/10.12934/jkpmhn.2025.34.S1.23
» https://doi.org/10.12934/jkpmhn.2025.34.S1.23 -
29 Klein A, Ayoub N, Juhel C, Schuller R, Armstrong F, Pegalajar-Jurado A. Performance of a gelling fibre dressing in management of wounds in a community setting: a sub-analysis of the VIPES study. J Wound Care [Internet]. 2024 [cited 2025 Nov 19];33(7):464-73. Available from: https://doi.org/10.12968/jowc.2024.0125
» https://doi.org/10.12968/jowc.2024.0125 -
30 Kimiafar K, Sarbaz M, Tabatabei SM, Ghaddaripouri K, Mousavi AS, Raei M, et al. Artificial intelligence literacy among healthcare professionals and students: a systematic review. Front Health Inform [Internet]. 2023 [cited 2026 May 5];12:168. Available from: https://www.researchgate.net/publication/375600294_Artificial_Intelligence_Literacy_Among_Healthcare_Professionals_and_Students_A_Systematic_Review
» https://www.researchgate.net/publication/375600294_Artificial_Intelligence_Literacy_Among_Healthcare_Professionals_and_Students_A_Systematic_Review