 Solução da Equação de Transporte de Nêutrons via Redes Neurais Informadas por Física: uma abordagem pedagógica
Resumo
Neste trabalho, trazemos um material pedagógico sobre a equação de transporte de nêutrons aplicada na análise de reatores nucleares. A apresentação é dividida em dois momentos. No primeiro, é ralizada uma revisão sobre alguns conceitos de física nuclear, com a finalidade de deduzir a equação de transporte de nêutrons, e assim, na sequência resolver analiticamente tal equação para o reator nuclear crítico com formato cilíndrico. No segundo momento, uma revisão sobre redes neurais informadas por física é apresentada. Posteriormente a equação de transporte de nêutrons para o reator nuclear com formato cilíndrico em funcionamento crítico é resolvida com o uso das PINNs. Por fim, a solução analítica é comparada com a solução obtida por intermédio das PINNs, evidenciando que o método de solução via redes neurais é de fato promissor.
Palavras-chave:
Inteligência artificial; aprendizado de máquina; redes neurais informadas por física; PINNs; equação de transporte de nêntrons
Abstract
In this work, we present pedagogical text on the neutron transport equation as applied to the analysis of nuclear reactors. The presentation is divided into two main parts. In the first part, we review fundamental concepts of nuclear physics with the aim of deriving the neutron transport equation. We then proceed to solve this equation analytically for critical nuclear reactors with cylindrical geometry. In the second part, we provide a review of Physics-Informed Neural Networks (PINNs). Subsequently, the neutron transport equation for the reactor configuration previously discussed is solved using the PINN approach. Finally, the analytical solution is compared with the solution obtained through the use of PINNs, demonstrating that the neural network-based method is indeed a promising approach.
Keywords:
Artificial inteligence; machine learning; Physics-Informed Neural Networks; PINNs; neutrons transport equation
1. Introdução
As tecnologias nucleares, apesar de serem bastante mitificadas, fazem parte do nosso cotidiano. Seja por meio de um exame de radiodiagnóstico, ou pelo consumo de alimentos conservados com uso de radiação, ou mesmo pela utilização de energia elétrica oriunda de uma usina nuclear, estamos imersos no universo da física nuclear. Dessa forma, compreedê-la nos ajuda a mitigar preconceitos existentes acerca da área nuclear e nos proteger contra o mau uso dessa fonte energética. Contudo, materiais instrucionais sobre energia nuclear escritos em língua portuguesa são escassos, sobretudo os destinados ao público leigo. Em particular, apesar de constar na literatura de língua inglesa bons materiais didáticos que discutem física de raetores nucleares, como por exemplos as referências [1, 2, 3, 4, 5, 6, 7, 8], tais bibliografias não encontram paralelo em língua portuguesa, comprometendo em parte, o aprendizado de alunos de graduação, bem como de interessados no assunto. Nessa perspectiva, este texto traz, num primeiro momento, uma revisão pedagógica acerca da equação de transporte de nêutrons, enfatizando os reatores nucleares críticos. Assim, soluções da equação de transporte nêutrons são apresentadas para o reator em formato cilíndrico. Tais soluções abarcam dois momentos: no primeiro momento são desenvolvidas analiticamente, e posteriormente são solucionadas mediante o uso de redes neurais informadas por física (PINNs).
O uso das PINNs (Physics-Informed Neural Networks) teve início de forma mais estruturada e reconhecida por volta de 2017, com destaque para os trabalhos pioneiros de Maziar Raissi, Paris Perdikaris e George Karniadakis. Esses pesquisadores propuseram formalmente a ideia de incorporar equações diferenciais (como leis físicas) diretamente no treinamento de redes neurais, de modo que a solução obtida respeitasse essas leis – mesmo em regiões sem dados. O trabalho de maior destaque nesse contexto, intitulado Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations, foi escrito em 2019 pelo trio consituído por Raissi, Perdikaris e Karniadakis [9]. Apesar de existirem estudos anteriores que combinavam aprendizado de máquina e modelagem física, foi esse trabalho que consolidou o termo PINNs e abriu caminho para uma ampla adoção da técnica em áreas como fluidodinâmica, física quântica, engenharia biomédica, dentre outras [10, 11, 12]. Desde então, o campo tem crescido rapidamente, com muitos avanços teóricos e práticos.
Nesse caminho, as Redes Neurais Informadas por Física representam um avanço significativo na interface entre aprendizado de máquina e modelagem científica. Sua importância reside na capacidade de incorporar diretamente leis físicas, expressas por equações diferenciais, dentro da estrutura de redes neurais, garantindo que as soluções obtidas respeitem os princípios fundamentais da física. Essa abordagem tem sido aplicada com sucesso em diversas áreas, sobretudo em física de reatores nucleares [13, 14, 15]. As PINNs são especialmente úteis para resolver equações diferenciais parciais e ordinárias em domínios complexos ou com dados escassos, onde métodos numéricos tradicionais enfrentam dificuldades. Ao conciliar dados empíricos e conhecimento físico, elas oferecem uma ferramenta robusta e flexível para simulações mais precisas e eficientes em problemas científicos e de engenharia. Nesse caminho, a nossa meta aqui foi incorporar, de uma forma simples e pedagógica, as PINNs na solução da equação de transporte de nêutrons para reatores nucleares críticos no formato cilíndrico; e no fim, comparar as soluções obtidas via PINNs com as soluções analíticas corriqueiras, também apresentadas neste trabalho. Com isso, almejamos que este trabalho auxilie o leitor, sobretudo o indivíduo lusófono, na compreensão de temas mais complexos tanto do arcabouço relativo à física de reatores nucleares, como no estudo de redes neurais informadas por física. Essa expectativa justifica-se em decorrência do trabalho apresentar uma sólida e cuidadosa revisão sobre a física de nêutrons, apresentando a equação de transporte aplicada no contexto de reatores nucleares, bem como por ter trazido uma discussão muito detalhada sobre PINNs, destinada principalmente a que está sendo introduzido no assunto.
Nessa perspectiva, a apresentação deste trabalho segue a sequência: na seção 2, uma revisão detalhada sobre a equação de transporte de nêutrons é destacada, trazendo ao leitor conceitos importantes como seção de choque e fluxo de nêutrons; na seção 3, aplicamos a equação de transporte de nêutrons na análise de reatores nucleares críticos de formato cilíndrico, obtendo, de forma detalhada, as soluções analíticas; na seção 4, apresentamos uma revisão sobre redes neurais informadas por física; na seção 5, trazemos as soluções para a equação de transporte obtidas com o uso de PINNs; por fim, na seção 6, as considerações finais e perspectivas são elencadas.
2. A Equação de Transporte de Nêutrons
Nesta seção, apresentaremos uma dedução da equação de transporte de nêutrons elencando algumas consequências físicas oiundas de sua interpretação.
A difusão de qualquer substância (neste texto, entenda-se por substância qualquer elemento que flua, seja um gás ou mesmo um grupo de partículas) é um problema já bem delineado pela física. Nesse sentido, o formalismo geral que será apresentado aqui seguirá de perto problemas análogos como a propagação do calor ou de um gás através de um dado meio. Nesse ideário, o leitor já deve ter vivenciado a situação de estar numa sala onde é aberto um recipiente de perfume. Nos instantes iniciais, após a abertura do frasco, apenas as pessoas que estão mais próximas sentirão o cheiro do perfume, mas após algum tempo, pessoas que estejam mais afastadas do recipiente poderão sentir o odor da substância. Isso ocorre porque o odor se difunde pela sala, e sua difusão obedece algumas leis e equações, como a lei de Fick e a equação de transporte, que veremos na sequência. O problema da difusão de nêutron é similar ao do perfume, ou seja, os nêutrons também se difundem por um dado meio, e o comportamento dessas partículas enquanto se difundem pode ser modelado por equações análogas à do perfume. Contudo, no caso dos nêutrons aparecem alguns ingredientes adicionais, pois a colisão de nêutrons com algumas partículas, como núcleos de urânio, podem levar ao surgimento de outros nêutrons, e essa particularidade deve ser incluída nas equações, o que será feito na dedução das equações próprias desse sistema.
2.1. O fluxo de nêutrons
A equação que descreve a difusão de uma dada substância representa a evolução temporal que descreve alguma característica da substância. Por exemplo, a equação de difusão do calor é representada pela evolução da quantidade de calor num dado ponto do espaço num dado instante. No caso da difusão dos nêutrons, a grandeza física que será utilizada como função a ser determinada é o fluxo de nêutrons, que será descrito a seguir.
O fluxo de nêutrons é definido por
em que representa a densidade de nêutrons, isto é, o número de nêutrons por centímetro cúbico numa dada região, e representa a velocidade média dos nêutrons (consideraremos neste rabalho apenas nêutrons monoenergéticos, isto é, com a mesma velocidade). Perceba que a unidade do fluxo de nêutrons é nêutrons por centímetro quadrado por segundo (). O fluxo de nêutrons, em geral, é uma grandeza que depende da posição espacial e do tempo.
Em física nuclear, é usual trabalhar com uma grandeza denominada seção de choque, denotada por , a qual fornece a probabilidade de uma partícula colidir com a outra. A seção de choque é geralmente determinada experimentalmente, e depende de alguns parâmetros, como por exemplo da energia cinética (ou velocidade) da partícula incidente (é usual adotar um referencial em que uma das partículas esteja em movimento (a partícula incidente) e a outra esteja parada (partícula alvo). Assim, em materiais de física nuclear, há tabelas que contêm seções de choques para vários pares de partículas com diferentes velocidades. Na essência, a seção de choque (ou seção eficaz, em inglês cross section) representa a probabilidade de ocorrência de uma interação entre um nêutron e um núcleo atômico. Essa interação pode ser:
-
Dispersão elástica ou inelástica (o nêutron colide e desvia, com ou sem perda de energia),
-
Absorção (o nêutron é capturado),
-
Fissão (em núcleos fissionáveis como o U-235).
A seção de choque é medida em unidades de área, sendo o barn () a unidade padrão:
A seção de choque total é a soma de todas as seções de choque parciais:
em que representa a seção de choque total, representa a seção de choque de dispersão ou espalhamento (scattering), e representa a seção de choque de absorção (inclui fissão, captura, etc.). Vale a pena enfatizar que a seção de choque de fissão é uma subcategoria da seção de choque de absorção, ou seja, a seção de choque de fissão é a soma das seções de choque de fissão, captura radiativa, dentre outras.
A seguir, na Tabela 1, apresentamos alguns valores das seções de choque dos isótopos U-235 (urânio-235) e U-238 (urânio-238) para nêutrons térmicos (ou lentos), isto é, nêutrons com energia cinética de .
Na Tabela 1, como pode ser percebido, a seção de choque de absorção total é a soma seção de choque de fissão com a seção de choque de captura radiativa, enquanto a seção de choque total é igual a soma da seção de choque de absorção total com a seção de choque de espalhamento. O U-235 é fissionável com nêutrons térmicos, por isso tem uma seção de choque de fissão muito alta a baixas energias. Já o U-238 só sofre fissão com nêutrons rápidos, e sua seção de choque de fissão térmica é praticamente desprezível. Esses valores mudam bastante em energias mais altas (região epitérmica ou rápida).
A Figura 1 traz o gráfico das seções de choque dos isótopos U-235 e U-238, mostrando a dependência desse parâmetro com a temperatura ou com a energia cinética dos nêutrons.
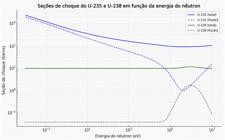
Dependência da seção de choque dos isótopos U-235 e U-238 em função da energia cinética dos nêutrons (Fonte: autoria própria).
No gráfico, as linhas contínuas mostram a seção de choque total, enquanto as linhas tracejadas mostram a seção de choque de fissão. Conforme podemos notar, o U-235 tem uma seção de fissão muito alta em nêutrons térmicos (à esquerda do gráfico), o que o torna ideal para reatores nucleares térmicos. Enquanto isso, o U-238 praticamente não sofre fissão com nêutrons térmicos, mas a seção de fissão aumenta com a energia, tornando-o relevante em reatores rápidos.
Se multiplicarmos a densidade atômica pela seção de choque , obtemos um parâmetros denominado seção de choque macroscópica, denotada por ,
Assim como a seção de choque é definida para cada tipo de interação, a seção de choque macroscópica também. Por exemplo, a seção de choque de absorção do U-235 e U-238 para nêutrons com energia cinética de são e , respectivamente. Como as densidades atômicas de U-235 e U-238 no urânio natural são e , respectivamente; então, a seção de choque macroscópica de absorção do U-235 e U-238 para os nêutrons térmicos são, respectivamente, e . Assim, a seção de choque macroscópica de absorção do urânio natural é dada por .
Perceba que se conhecemos o fluxo de nêutrons, isto é, o número de nêutrons em cada centímeto quadrado de uma dada região em cada segundo, e também a seção de choque total das partículas-alvo disponíveis nesta região, podemos calcular a quantidade de colisões que ocorrerão por centímetro cúbico por segundo nesta região mediante o produto
em que é denominado densidade de colisões. Esse é mais um parâmetro relevante na engenharia nuclear. De posse desses parâmetros, podemos discutir o próximo ponto: a lei de Fick.
2.2. A Lei de Fick
A teoria da difusão é baseada na lei de Fick. Tal lei foi originalmente utilizada na difusão química. É de conhecimento que quando, numa solução, a concentração de determinado soluto numa região é maior do que em outra, o soluto se difunde da região de maior concentração para a de menor concentração. Além disso, sabe-se também que a taxa com que o soluto flui é proporcional ao negativo do gradiente da concentração do soluto. Os nêutrons, em certas condições, possuem o comportamento similar ao do soluto numa solução. Isto é, se a desnidade ou o fluxo de nêutrons for maior numa região de um reator do que em outra, existirá uma corrente de nêutrons fluindo da região de maior densidade para a de menor densidade. Assim, se considerarmos que o fluxo varia ao longo da direção , a lei de Fick fica dada por [6, 8]
em que é o coeficiente de difusão, o qual depende de parâmetros relacionados ao sistema analisado; no caso considerado, depende dos parâmetros associados ao meio em que os nêutrons estão fluindo. é denominada densidade de corrente de nêutrons, sendo uma medida do número de nêutrons que passa, por unidade de tempo, através de uma unidade de área perpendicular à direção . A unidade de é a mesma do fluxo, isto é, .
Se o fluxo é função das três coordenadas espaciais, definimos
em que é denominado vetor densidade de corrente de nêutrons. O significado físico de pode ser obtido se considerarmos o produto escalar
onde é o vetor normal unitário numa direção arbitrária. obtido é igual à quantidade de nêutrons por segundo que atravessam uma unidade de área normal à direção definida por .
A fim de compreendermos melhor esses conceitos, consideremos que uma fonte de nêutrons pontual que emita nêuntrons por segundo possua o fluxo de nêutrons dado por
em que é a distância radial da fonte até algum ponto, é o coeficiente de difusão, e é uma constante. A partir deste fluxo, podemos calcular a corrente. Notemos que depende apenas de . Assim, se tomarmos o operador gradiente em coordenadas esféricas, considerando apenas a componente radial, temos que , em que é o vetor unitário na direção radial. Assim, a densidade de corrente, que também só terá componente na direção radial, é dada por
que no caso em tela é dado por
a partir de que obtemos
A partir de , podemos calcular a quantidade de nêutrons por segundo que atravessam uma unidade de área normal à direção definida por . Para isso, notemos que no caso considerado é sempre perpendicular à superfície de uma esfera. Assim, nos fornece a quantidade de nêutrons que atravessam cada unidade de área da esfera. E assim, a quantidade de nêutrons que, a cada segundo, atravessam a esfera inteira é dada por , o que nos fornece .
Para finalizar esta subseção, vamos discutir o significado do coeficiente . Lembrando que e possuem a mesma unidade e visualizando a Eq. (3), percebemos que tem que ter dimensão de comprimento. Pode-se mostrar (o que é muito longo para ser feito aqui neste texto introdutório), que o coeficiente de difusão pode ser escrito como [8]
em que é o valor médio do cosseno do ângulo que os nêutrons são espalhados após a colisão com as partículas-alvo. Para os núcleos mais usados nos reatores, pode ser calculado por meio de
onde é o número de massa atômica da partícula-alvo. Se definirmos o livre caminho médio de transporte como
podemos reescrever na forma simples
2.3. A equação de continuidade
Outro ingrediente fundamental para a obtenção da equação de transporte de nêutrons é a equação de continuidade. Essa equação aparece nas mais variadas áreas da física, de forma que o leitor já possa ter se deparado com ela em outros contextos. A fim de obtê-la para o caso dos nêutrons, consideremos um volume arbitrário no qual há nêutrons e outras partículas. Com o passar do tempo, a quantidade de nêutrons dentro de pode mudar por algum dos seguintes processos: se nêutrons escaparem para fora de , se nêutrons forem absorvidos por alguma pártícula presente em , ou se fontes emissoras de nêutrons estão presentes em . A equação de continuidade, a qual será obtida nesta subseção, é nada mais que a linguagem matemática para dizer que, ao levarmos em conta os três processos descritos, a quantidade de nêutrons deve se conservar.
Resumidamente, podemos escrever que a taxa de variação do número de nêutrons em V é igual à taxa com que os nêutrons são produzidos em , subtraído da taxa que os nêutrons são absorvidos em , subtraído também da taxa com que os nêutrons escapam de . Temos que contabilizar cada termo sugerido neste resumo.
Com a finalidade de contabilizarmos a variação do número de nêutrons com o tempo, consideremos como a densidade de nêutrons em qualquer ponto em . Assim, o total de nêutrons em é dado por
onde a integração é realizada em todo o volume .
A taxa de variação do número de nêutrons é dada por
Para computarmos a taxa de produção, consideremos que os nêutrons são emitidos por uma fonte localizada em que produza nêutrons por centímeto cúbico a cada segundo. Assim, a taxa de produção é dada por
Com essa integral obtemos o número de nêutrons produzidos no volume a cada segundo.
A taxa de absorção por centímetro cúbico por segundo é dada por , em que é a seção de choque macroscópica da partícula-alvo (essa partícula-alvo, que no reator nuclear pode ser o núcleo de U-235, poderá absorver o nêutron após a colisão). Assim, a taxa de absorção é dada por
Após o cálculo dessa integral, obtemos o número de nêutrons absorvidos dentro de a cada segundo.
A taxa de escape de nêutrons é encontrada por meio da densidade de corrente de nêutrons. Para isso, considere como o vetor densidade de corrente na superfície de e é o vetor normal unitário direcionado para fora da superfície. Assim, sabemos que nos fornece o número de nêutrons que atravessam a superfície que delimita - de dentro para fora - por . Com isso, a taxa de vazamento é dada por
Como é uma superfície fechada, podemos usar o teorema da divergência e reescrever a taxa de vazamento como
Nesse caminho, a taxa com que a quantidade de nêutrons dentro de varia com o tempo é dada por
Como todas as integrais estão relacionadas ao mesmo volume, podemos escrever
que é a forma geral da equação de continuidade. Nos casos em que a densidade de nêutrons não é função do tempo, obtemos
que é equação de continuidade do estado estacionário.
2.4. A equação de transporte
Se substituirmos a Eq. (4) na Eq. (6), obtemos
que é a equação de transporte de nêutrons.
Para o caso estacionário, obtemos
a qual pode ser escrita na forma
em que é denominado comprimento de difusão, termo que aparece com frequência na engenharia nuclear.
A Eq. (10) é a equação de difusão de nêutrons estacionária mais genérica, ainda não adaptada para a análise de um retator nuclear. Em breve faremos essa adaptação. Antes disso, vamos aplicá-la a uma situação prática.
2.4.1. Uma placa infinita irradiando nêutrons
Consideremos uma fonte de nêutrons que seja um plano infinito que emite nêutrons por . Se considerarmos que o plano é o , localizado em , podemos admitir que o fluxo é uma função apenas da coordenada , que é a distância de onde o fluxo é medido até o plano. Assim, podemos considerar que não há fontes em nenhum outro ponto além de , ou seja, utilizaremos a fonte no plano como uma condição de contorno. Dessa forma, a Eq. (10) pode ser escrita para este caso como
A solução geral da Eq. (11) é dada por
em que e são constantes a serem determinadas com o uso das condições de contorno. Por ora, consideraremos apenas . Assim, para que o fluxo seja finito, o coeficiente deve ser nulo. Dessa forma, o fluxo de nêutrons fica dado por
O coeficiente é determinado com o uso do fato de que na origem, em , há uma fonte que emite nêutrons por centímetro quadrado por segundo. Como o plano emite nos dois sentidos, admitamos, por simetria, que no sentido a emisão seja de nêutrons por centímetro quadrado por segundo. Dessa forma, a condição de contorno nos diz que
A partir da lei de Fick, podemos escrever
Logo, usando a condição de contorno, temos que
E assim, o fluxo para é dado por
Se quisermos uma solução que valha também para , por simetria, basta que escrevamos
Os resultados deste exemplo serão utilizados num caso mais complexo que trataremos a seguir.
2.4.2. Uma placa infinita irradiando nêutronsnuma região fechada
No próximo exemplo, consideraremos o plano infinito do exemplo anterior, irradiando nêutrons a uma taxa nêutrons por centímetro quadrado por segundo, envolto pelos dois lados por paredes infinitas. Consideremos que o plano que irradia esteja localizado na origem do sistema de coordenadas, em , e a uma ditância de ambas as paredes. Ou seja, a parede da esquerda está localizada em , enquanto a da direita está em . A equação que devemos resolver é a mesma do exemplo anterior, Eq. (11) pois consideraremos a placa irradiando como uma condição de contorno, isto é,
A solução é dada por , e aqui não podemos assumir nenhuma das duas constantes como nula, já que o sistema não inclui o infinito, pois é limitado pelas paredes.
Agora, além dessa condição, temos também que o fluxo de nêutrons nas paredes deve ser nulo, ou seja,
Assim, temos então
e
Com isso, podemos escrever , e a solução será
A constante pode ser determinada, como no exemplo anterior, com a condição da fonte . Usando a lei de Fick obtemos:
E assim,
Logo, para , obtemos
Por simetria, a solução válida para qualquer valor de é dada por
Multiplicando o numerador e o denominador da Eq. (13) por , chegamos a
Agora, usando as funções trigonométricas hiperbólicas, isto é e
, a Eq. (14) passa a ser escrita na forma
Neste ponto, é importante comentarmos que a condição de contorno não é uma condição física, pois o fluxo de nêutrons não é realmente nulo nas paredes; caso fossem, não haveria corrente de nêutrons através das paredes, e nenhum nêutron seria encontrado além delas. Assim, na verdade nas paredes. Sob um ponto de vista mais formal, a diferença reside na condição de fronteira que adotamos, ou seja, utilizamos a condição de Dirichlet, na qual o nó se encontra rigorosamente na fornteira. A abordagem fica fisicamente mais aceitável caso utilizássemos a condição de Marshak [16], na qual o nó encontra-se fora do domínio físico, isto é, numa fronteira extrapolada. De forma simplificada, na condição de Dirichlet, o fluxo cai abruptamente para zero na parede, enquanto na de Marshak, o fluxo atinge zero um pouco depois da parede. Em síntese, na condição de Marshak, a extrapolação da fornteira pode ser escrita como , em que . O valor mais preciso da teoria de transporte é . Esse resultado advém da condição
o que implica também . Optamos por não deduzir aqui os detalhes do último resultado mostrado. Na prática, continuaremos usando a condição de Dirichlet, mas compreendendo que, fisicamente, há fluxo de nêutron na parede, o que possibilita a corrente de nêutrons através dela, e assim, o vazamento de nêutrons nos casos reais. Assim, com o intuito de simplificar os cálculos, continuaremos a utilizar a condição de Dirichlet.
Com tal explicação concluída, podemos retomar a discussão prática sobre os planos infinitos. A Eq. (15) nos fornece bastante informação acerca do sistema considerado. Por exemplo, suponha que queiramos determinar o número de nêutrons que escapa do sistema por segundo de cada através das duas paredes. Para isso, é suficiente calcularmos a corrente de nêutrons na parede, ou seja, em e em e adicionarmos os dois resultados.
Fazendo isso, a partir da Eq. (15) podemos deduzir que
Logo,
Da mesma forma,
E assim, a quantidade de nêutrons que escapa do sistema por segundo de cada através das duas paredes é igual a , ou seja,
A partir deste resultado, podemos determinar a probabilidade com que os nêutrons emitidos possam vazar pelas paredes. Se a fonte emite nêutrons por centímetro quadrado por segundo e se escapam , essa probabilidade é dada por
Esses cálculos, apesar de serem relativamente simples, são muito importantes na elaboração de projetos de blindagem, quando se quer reduzir a quantidade de nêutrons que escapam de determinado sistema.
2.5. A equação de transporte de nêutronsno contexto do reator nuclear
Nesta subseção, deduziremos a equação de transporte de nêutrons apropriada para se analizar o fluxo de nêutrons num reator nuclear. Consideraremos o modelo mais simples que simula um reator nuclear: um reator rápido e crítico contendo uma mistura de combustível e refrigerante, consistindo de apenas uma região. Este reator é denominado reator nú e a dinâmica dos nêutrons em seu interior podem ser descritos pela Eq. (10), isto é,
No reator crítico, o que estamos considerando aqui, são os nêutrons emitidos na fissão. Aqui vale recordar que quando um nêutron atinge um núcleo de urânio-235, ele pode ser absorvido, formando um núcleo instável de urânio-236, que se divide em dois fragmentos menores (núcleos fi-lhos) e libera mais nêutrons, além de uma grande quantidade de energia.
A reação mais geral pode ser escrita como
Um exemplo específico de fissão é
A energia liberada é em torno de por fissão. Dessa forma, a fonte de nêutrons pode ser dada por
em que é o número médio de nêutrons emitidos por fissão, e é a seção macroscópica de choque total do combustível.
Notemos que o termo de fonte pode ser reescrito como
em que a razão é denominado fator de utilização e é a seção macroscópica de choque da mistura combustível e refrigerante. Assim, é igual a fração de nêutrons absorvidos no reator e que de fato são absorvidos no combustível. Ou seja, fornece a fração de nêutrons que de fato podem provocar a fissão no urânio-235.
O produto é denominado fator de multiplicação de um meio infinito, representado por . Um meio infinito é definido como um meio em que não há perda de nêutrons por fuga.
De forma geral, o fator de multiplicação, geralmente representado por
é um parâmetro fundamental na física de reatores nucleares. Ele indica a razão entre o número de nêutrons na geração atual e o número de nêutrons na geração anterior. Esse parâmetro pode ser classificado em dois tipos, o fator de multiplicação efetivo, , que leva em conta todas as perdas de nêutrons no reator, como nêutrons que escapam do reator e nêutrons absorvidos sem causar fissão; e o fator de multiplicação infinito (já mencionado anteriormente), .
O valor de pode ser interpretado com os seguintes critérios:
-
– Subcrítico: A reação de fissão está diminuindo; o reator "morre"com o tempo.
-
-– Crítico: A reação está estável. Cada geração de nêutrons mantém a próxima. É o estado desejado para operação contínua de um reator.
-
-– Supercrítico: A reação está se intensificando. O número de nêutrons (e a potência) cresce com o tempo.
Com isso, o termo de fonte pode finalmente ser escrito como
Subsituindo na Eq. (10), obtemos
em que
Nas (equações 16) e (17) temos o termo que é referido em inglês pela palavra Buckling medida em cm-2. Essas equações serão aplicadas na próxima seção para o estudo do reator nuclear cilíndrico.
3. Solução Analítica da Equação de Transporte de Nêutrons aplicadas a reatores nucleares
Nesta seção, o nosso objetivo é aplicar a Eq. (16) para analisar reatores nucleares. Consideraremos nesta abordagem analítica o reator no formato cilíndrico, que é o caso mais comum em usinas nucleares, sobretudo nas usinas PWR [5]. Esperamos que esta seção forneça ao leitor subsídios que o auxilie na compreensão da física de reatores nucleares, sobretudo dos conceitos envolvidos no projeto de retatores.
Nesse caminho, vamos considerar o reator cilíndrico de raio e altura . Devido à simetria do problema, optamos por utilizar coordenadas cilíndricas . Em nossa análise, consideraremos o caso em que o fluxo de nêutrons não dependa da coordenada . Assim, o laplaciano apenas com a dependência em e é dado por
Com isso, a Eq. (16) fica escrita na forma
Assim, como foi feito na seção precedente, vamos supor que a solução seja dada por . Assim, obtemos as seguintes equações diferenciais ordinárias
onde e são as constantes de separação, e satisfazem
A solução da Eq. (20) é dada por
Utilizando a condição de contorno que o fluxo deve ser nulo nas tampas do reator (bases do cilindro), e , encontramos que a solução deve ser uma função par que satisfaça .
Isso nos fornece para o reator crítico
ou seja,
E assim, a solução da parte em fica dada por
Agora retomamos à solução da parte radial. Após manipulação, a Eq. (19) pode ser reescrita na forma
Essa equação é um caso particular da equação diferencial de Bessel, que é dada dada por [17]
Ou seja, a Eq. (24) é a equação diferencial de Bessel, Eq. (25), com . Sua solução é bem conhecida na literatura, pois é dada em termos de [17]
em que e são constantes, enquanto e são, respectivamente, a função de Bessel e a função de Neumann de ordem zero. Todas as identidades e propriedades sobre as funções de Bessel que utilizamos podem ser encontradas na referência. Enquanto a função de Bessel é bem comportada para qualquer valor da variável, a função de Neumann diverge na origem, ou seja, . Como o nosso problema envolve a origem, ou seja, o núcleo do reator cilíndrico, localizado em , faz parte do sistema analisado, o coeficiente da Eq. (26) deve ser igual a zero. Por isso, a solução da parte radial fica dadapor
Usando a condição de contorno que o fluxo deve ser nulo na lateral do cilindro, em , temos
Como estamos interessados no reator crítico, apenas a primeira raiz da função de Bessel de ordem zero é relevante. Essa raiz é igual a [17]. Assim,
E a solução da parte radial toma a forma
Com isso, a solução do problema fica a princípio dada por
em que é uma constante que determinaremos a seguir.
Assim, como comentamos no caso dos planos infinitos, a condição de Dirichlet, na fronteira da região considerada (tampas e laterais do cilindro), é apenas uma condição matemática. Na prática, o fluxo de nêutrons não é nulo na fronteira, pois se assim fosse, nêutrons não vazariam do reator. Na verdade, temos que , o que advém da condição de Marshak [16], isto é,
nas laterais do cilindro (), e
nas tampas do cilindro (). Na prática, trocamos e , em que , nas equações oriundas da solução do reator, inclusive na Eq. (17). Como este trabalho tem cunho meramente pedagógico, continuaremos a admitir a condição de Dirichlet (entendendo-a apenas como formalidade matemática), mas sabendo que na realidade o fluxo de nêutrons não se anula nas fronteiras da região analisada.
A potência, grandeza física que se conhece (a priori) ao se projetar um reator, pode ser calculada por meio da integral [8]
o que no caso considerado é igual a
Lembremos que o jacobiano em coordenadas cilíndricas é igual a .
A integral em é facilmente calculada e resulta em .
Com isso, ficamos com
Para calcular a integral em devemos lembrar que
Com isso, a integral em é dada por
Ou ainda
O que nos fornece
Podemos escrever a expressão anterior na seguinte forma
Essa última expressão pode ser escrita em termos da função de Bessel de ordem 1, , ou seja
Lembrando que , a Eq. (32) fica dada por
Assim,
E assim, a solução final do problema é
Agora, vamos calcular a quantidade de nêutrons que escapam do reator a cada segundo. Para isso, precisamos calcular a densidade de corrente. O operador gradiente nem coordenadas cilíndricas é dado por
Como para o caso considerado o fluxo de nêutrons não depende de , temos que os componentes não-nulos da densidade de corrente de nêutrons são
e
Usando a relação , temos
e ainda,
Calculando o fluxo através das paredes do reator, , obtemos
e
No cálculo do fluxo através da base e tampa do reator foi usada a relação . Com isso, a quantidade de nêutrons que escapa por segundo através das paredes do reator é dada por
Os resultados estabelecidos nesta seção serão comparados aos obtidos a partir das PINNs.
4. O Que é Uma Rede Neural Informada Por Física (PINN)?
Recentemente tivemos grandes avanços com as redes neurais para se fazer previões baseadas e dados de pré-treinamento. Aplicações em deep learning desde reconhecimento de imagens, identificação de padrões em grandes volumes de dados, análise de tendências com aplicações no mercado financeiro e, principalmente, o desenvolvimento de Large Language Models (LLMs) para facilitar a interface máquina-humano. Nos últimos anos, tem sido proposto o treinamento de redes neurais para a resolução de equações diferenciais parciais (EDP), através das redes neurais informadas pela física (PINNS em inglês), tanto para a resolução na forma direta quanto na forma indireta. A resolução de uma EDP na forma direta refere-se ao fato de, dadas as condiçoes de contorno, as soluções são previstas através da equação diferencial proposta com os coeficientes em suas formas funcionais conhecidos. O problema inverso refere-se a descobrir os coeficientes a partir de dados conhecidos.
Em ambos os casos, podemos destacar as vantagens em usarmos PINNs ao invés de outros métodos com um custo computacional maior como o método de elementos finitos (MEF):
-
Dispensam discretização espacial:
-
–
É necessária uma malha computacional para o MEF, o que pode ser complexo em geometrias irregulares ou em altas dimensões.
-
–
As PINNs aprendem a solução diretamente a partir das coordenadas espaciais (ou temporais), sem necessidade de discretização.
-
–
-
São mais indicadas para dados incompletos ou ruidosos:
-
–
Os dados experimentais podem ser incorporados diretamente pelas PINNs, mesmo que esparsos ou ruidosos, ajustando a solução de forma híbrida (física + dados).
-
–
O MEF depende fortemente de condições de contorno bem definidas.
-
–
-
Tratamento Natural de Problemas Inversos:
-
–
O MEF resolve, na grande maioria dos casos, problemas diretos, enquanto as PINNs podem inferir parâmetros desconhecidos da equação (problemas inversos) de forma mais direta.
-
–
-
Comprovadamente, tem menor custo computacional em problemas de alta dimensionalidade:
-
–
O MEF sofre com a “maldição da dimensionalidade” (ex.: problemas 3D+tempo exigem malhas extremamente finas).
-
–
As PINNs aproximam a solução com uma rede neural, que pode ser mais eficiente em domínios complexos.
-
–
-
Suavidade da solução:
-
–
As PINNs fornecem soluções infinitamente diferenciáveis (útil para calcular derivadas da solução).
-
–
O MEF geralmente usa funções de bases contínuas por partes, limitando a suavidade.
-
–
-
Facilidade em problemas multifísicos e acoplados:
-
–
As PINNs podem incorporar múltiplas leis físicas simultaneamente na função de perda.
-
–
No MEF, modelos multifísicose exigem acoplamento complexo entre diferentes formulações.
-
–
Contudo, devemos destacar algumas desvantagens das PINNS. O treinamento pode ser demorado, pois redes neurais profundas exigem ajuste fino e podem ter convergência lenta. Uma outra desvantegem que merece destaque é a dificuldade em capturar soluções com descontinuidades, pois o MEF lida melhor com choques ou descontinuidades (ex.: escoamentos compressíveis). Porém, seu uso vem se ampliando e os modelos vêm sendo cada vez mais validados, constituindo uma nova área de desenvolvimento para possíveis aplicações Físicas e industriais.
4.1. Redes Neurais informadas pela Física(PINNs)
O termo “informadas pela Física” advém do fato de definirmos a taxa de perda (loss rate) a partir da EDP em questão. Em nosso caso, queremos resolver uma equação diferencial dada na forma:
que é uma equação diferencial parcial do tipo Helmholtz, no qual como já foi explicado anteriormente.
Agora, queremos aproximar a solução com uma rede neural. Para tanto, considere a rede neural diagramada pela Figura 2. A questão aqui é que queremos aproximar a solução tal que:

onde denota uma função com parâmetros a ser treinada pela rede neural. Esta deve ser organizada em camadas de neurônios. A primeira camada é a chamada camada de entrada que deve conter as variáveis, ou seja,
Cada camada subsequente será então parametrizada por um peso e por um bias, onde é definido como tamanho da saida da camada . As camadas são chamadas de camadas escondidas densas cuja saida de cada uma é definida recursivamente como sendo:
onde é chamada de função de ativação não-linear que especificaremos mais adiante. Ao final do processo, na camada de saída que terá apenas um valor será então dada por:
onde, finalmente, .
Diagramaticamente, na Figura 2, temos a camada de entrada representada por 3 neurônios para abrigar os valores de e . Seguem então mais 3 camadas densas escondidas de 4 neurônios cada, finalizando na camada de saída . Neste caso, temos que e a chave é definirmos quem são as respectivas taxas de perda (loss rate), o que faremos logo abaixo. O número de parâmetros a serem treinados seguem a fórmula . No caso da Figura 2 temos que (número de parâmetros de entrada), (número de neurônios por camada densa escondida) e (número de parâmetros de saída), totalizando 61 parâmetros a serem treinados pela rede neural. Este é apenas um exemplo esquemático mais simples para explicarmos o que faremos a seguir.
Na Figura 3 temos o dimensionamento real de parâmetros que usaremos em nossa PINN que serão , e , totalizando 25.281 parâmetros de treinamento da rede neural. A fim de capturarmos as particularidades da PDE em todos os pontos avaliados no cilindro nós utilizaremos 7 camadas densas de neurônios escondidos. Para tando, é necessário utlizarmos uma topologia de rede neural um pouco mais sofisticada para evitarmos um explosão de gradientes. Isso é alcançado criando-se “atalhos” através de add layers entre as camadas densas escondidas. Isso é feito automaticamente pelo tensorflow através da flag “PINN_ResNet” ao construirmos o modelo, como veremos a seguir no programa. O tensorflow mostra inicialmente a camada de entrada se conectando à primeira camada densa escondida como na Figura 2 e, em seguida, a concexão com as demais. Dessa forma, o tensorflow adicionará os add layers a cada duas camadas densas escondidas, criando os mencionados “atalhos” para os gradientes de aprendizado ao longo da rede. Vale ressaltar que esses add layers não contribuem com novos parâmetros de treinamento e são apenas vias de fluxo para os gradientes gerados entre cada duas camadas. Essa é uma característica fundamental distinta dessas redes, o que não ocorre com as redes sequenciais usuais como a da Figura 2.

A técnica que empregaremos é a aproximação por aprendizado supervisionado usando dados de treinamento que, em nosso caso, serão os valores conhecidos da função em e no ponto central. Seja então, o conjunto com desses dados, , para treinamento:
Assim, será considerada uma boa aproximação se as previsões de estiverem próximas de para cada . Ou seja, queremos o conjunto de parâmetros otimizados tais que:
com
que é o erro quadrático médio que define a taxa de perda com relação aos dados de treinamento.
Ao resolvermos a Eq. (44) estaremos otimizando os parâmetros com relação aos dados de treinamento que, em nosso caso, serão os pontos em e no ponto central, como mencionamos logo acima. Na verdade, para resolvermos esta equação de otimização utilizamos o algoritmo de gradiente descendente ou backpropagation. Esse algoritmo depende de uma diferenciação automática que é realizada sem problemas pelo Tensorflow sobre . Esta tarefa é realizada dentro de uma tolerância desejada através de:
com para a -ésima iteração que chamamos de época. é a taxa de aprendizado e deve ser otimizado para algumas rodadas iniciais. Se for muito pequeno demorará muito a convergir e se for grande não otimizará corretamente os parâmetros. Então, rodamos para um número pequeno de épocas e ajustamos o seu valor que geralmente fica em torno de 10-3 a 10-2, inicialmente. Vamos utilizar como otimizador o chamado adaptive moment estimation (ADAM) que ajusta a taxa de aprendizado dos parâmetros durante o treino, a partir de um valor inicial que estipulamos acima do valor final desejado. Essa técnica de resolução é chamada de Vanilla-PINN[18].
5. Soluções da Equação de Transporte de Nêutrons obtidas a partir das PINNs
Nesta seção, apresentamos a solução do reator cilíndrico via PINN; e para esse fim será usado o conteúdo discutido nas duas seções precedentes. Assim, queremos resolver a Eq. (18) por meio do treinamento de uma PINN que satisfaça certas condições de contorno para um cilindro de altura e raio . Tal como fizemos anteriormente, definiremos um sistema de coordenadas e um fluxo de neutrons normalizados. Ao final dos cálculos teremos constantes multiplicativas que fazem o sistema reatornar às dimensões físicas reais, facilitando o treinamento das PINNs. Dessa forma, faremos as seguintes normalizações;
com
Dessa forma, não é difícil ver que a Eq. (18) se torna uma equação similar à equação de Helmholtz Eq. (38)
com e . Temos agora uma equação diferencial normalizada e parametrizada pela razão entre o raio e a altura e o parâmetro , com e .
No entanto, esta equação, tal como está, não é conveniente para o treino de uma PINN devido à singularidade em . Isso traz instabilidades ao modelo que não permitem o treinamento da PINN de forma correta. Para contornarmos isso, vamos reescrever o operador diferencial desta equação em coordenadas cartesianas para obtermos
Assim, a Eq. (33), que representa a solução analítica será dada por:
com e as condições de contorno dadas pela Eq. (38).
No listing 1, podemos ver as bibliotecas que serão necessárias para resolvermos a Eq. (38) utilizando as técnicas de aprendizado de máquina. A primeira biblioteca é a tensorflow que contém todas as ferramentas necessárias para o treinamento de modelos de redes neurais que serão utilizadas. A segunda é a biblioteca padrão para manipulações matemáticas e técnicas de vetorização chamada numpy que se integra perfeitamente com a biblioteca do tensorflow. A biblioteca scipy.special fornece as funções de Bessel utilizadas no cálculo. As demais bibliotecas matplotlib.pyplot e mpl_toolkits.mplot3d são bibliotecas de visualização dos resultados já bem estabelecidas do Python. Note que o parâmetro , definido acima , entra como e como _aH e, além disso, definimos a precisão do modelo no tensorflow em “float64”. Temos também os pesos para a taxa de perda com relação à EDP em questão, um ponto central onde será colocada a fonte e às condições de contorno, respectivamente com wpde, wcentere wbc.

No listing 2 mostramos a função que gera os pontos do mesh para treinamento. Adotamos as coordenadas cilíndricas e também mostramos a função que converte as coordenadas cilíndricas para cartesianas, pois utilizaremos com frequência essa transformação. Na Figura 4 mostramos os pontos do mesh gerados. Por padrão, a não ser que se queira aumentar o número de pontos do mesh, teremos: n_boundary=3000, n_domain=8000, o que significam 3000 pontos nas faces e 8000 pontos na região interna do cilindro. A lista boundary_values contém os valores da função nas fronteiras, ou seja, são os valores da condição de contorno sobre em todos os boundary_points. domain_points é uma lista com todos os pontos no interior do reator cilíndrico normalizado com e .


No listing 3 definimos a arquitetura de nossa rede neural e cada camada densa escondida é nomeada. Como vimos na Figura 3, utilizaremos 7 camadas com 64 neurônios cada. Essa parte é determinada por tentativa e erro. Devido ao ponto central, essa arquitetura se mostrou mais eficiente na convergência. Outras com menos hidden layers podem ser testadas aumentando-se o número de neurônios. Além disso, utilizaremos o ativador como sendo a função não linear “”, com o kernel inicializador glorot_normal, o que garante uma convergência mais rápida e estável, pois evita que os pesos iniciais impliquem uma explosão nos gradientes. Esse ativador é essencial para os cálculos uma vez que possui segunda derivada não nula, o que não acontece com ativadores lineares como “relu”. Isso se deve ao fato de estarmos lidando com operadores diferenciais de segunda ordem. Esta arquitetura está representada na Figura 3. Note que o InputLayer tem dimensão 3, embora estajamos interessados apenas nas coordenadas e . Na verdade, a solução da Eq. (18) utilizou da simetria com relação à variável angular . Dessa forma, teremos sempre o conjunto de variáveis que serão importantes na hora de convertermos para coordenadas cartesianas quando necessário, como veremos adiante. Essa é uma boa etratégia que ficará mais clara nos próximos listings. Por fim, note a flag “PINN_ResNet” na definição do modelo ao fim desta rotina. Como comentamos anteriormente, ela será responsável pela inclusão de “atalhos” para os gradientes, evitando que haja uma explosão destes.

No listing 4 definimos a a EDP a ser resolvida e a solução exata para comparação com o modelo. A implementação é feita através do decorador , utilizando a função tensorflow.GradientTape. O modo “persistent” é utilizado para que numa mesma operação de memória sejam calculadas as derivadas segundas da função. Aqui utilizamos dois GradientTape para calcularmos as derivadas segundas. Isso foi necessário devido ao fato de termos que transformar para coordenadas cartesianas para evitarmos problemas com ponbtos mal definidos devido ao ângulo , levando ao treinamento errático com pesos estagnados num ponto trivial. Como os textos explicativos no listing afirmam, o tensorflow calcula as derivadas em coordenadas cilíndricas internamente e reatorna os valores já convertidos. Dessa forma, o modelo é treinado em coordenadas cartesianas e a equação diferencial será resolvida integralmente em coordenadas cilíndricas.

No listing 5 temos a definição da taxa de perda total. Introduzimos a fonte de nêutrons no ponto central no qual o valor de , que coincide em coordenadas cartesianas em . A função compute_loss calcula a taxa total de perda do modelo e os reatorna com os respectivos pesos multiplicados. Essa é a função que será utilizada para otimizar o algoritmo e sua minimização é adotada como critério de convergência utilizando-se a Eq. (46). Um valor a partir de 10-5 é considerado um bom critério para convergência e, como veremos, refletirá na reprodução dos resultados analíticos até uma certa acurácia.

Diferentemente do treinamento das redes neurais tradicionais em que temos um conjunto de dados para treinamento e, após fazê-lo, utilizamos o modelo para fazer previsões, as PINNs utilizam a equação diferencial (ou equação física) para treinar ao mesmo tempo que faz previsões[9]. Isso só é possível porque a equação diferencial física fornece a lei que governa a EDP em todos os pontos do espaço em que queremos treinar a rede neural. Recentemente, houve uma explosão de trabalhos empregando PINNs para resolver EDPs em 2D na literatura[18]. Nota-se que ao empregar as EDPs normalizadas em módulo 1, o número de pontos de treinamento não precisa ser tão grande e a convergência ocorre relativamente de forma rápida. Em 3D, as coisas são diferentes. O fato de adicionarmos mais uma dimensão faz com que devamos adicionar muitos pontos para atingirmos certa acurácia. Contudo, realizar o treinamento ao mesmo tempo que as condições de contorno sejam fixadas nem sempre garante uma convergência computacional rápida e estável. Para tanto, devemos fazer um pré-treinamento apenas com as condições de contorno para que os parâmetros de treino reconheçam desde o início os valores da função explicitados pelas condições de contorno. Isso garante que a PINN convergirá em tempo hábil, como veremos a seguir. No listing 6 vemos a forma das funções de pré-treinamento e de treinamento de nossa rede neural. note a inclusão da função “tf.clip_by_global_norm” dentro do calculo do gradiente, o que garante a prevenção de “surtos” no gradiente. Além disso, veja que a perda total na otimização de pré-treino é definida como a perda nas faces com peso 100 mais a perda no ponto central com peso 10. Isso garante que os parâmetros iniciais para esses pontos já terão parâmetros pré-inicializados para que o modelo a ser treinado não comece tudo a partir do zero.

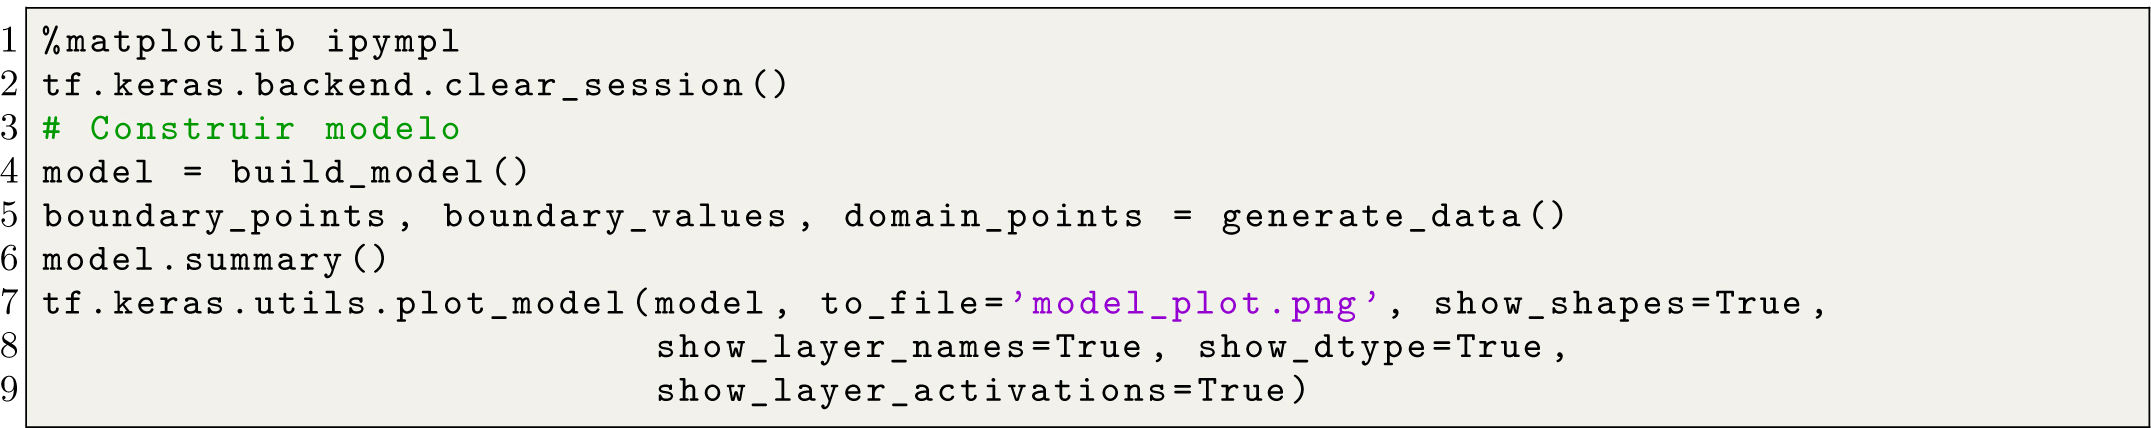
Agora, vamos construir o modelo com os pontos nos locais certos, gerando a Figura 4. Para tanto, basta digitar os comandos do listing 7 logo abaixo. Temos como saída também um esquemático com as redes neurais geradas através da instância “tf.keras.utils.plot_model”, o que gera a Figura 3. Note o comando %matplotlib ipympl que é um comando “mágico”, típico do uso do jupyter notebook, para efeitos de visualizações interativas. Aconselhamos o uso do jupyter para as simulções pois facilitam na identificação de erros.

Vamos então preparar a parte de visualização dos resultados. Temos no listing 8 a função “plot_results” na qual passamos o modelo treinado e o “loss_history” para visualização. As saidas estão em “resultados.png”, “resultados_2D.png” e “loss_rate.png”.

Finalmente, no listing 9 fazemos o pré-treinamento e o treinamento da PINN para gerar os resultados e visualizá-los nos gráficos.

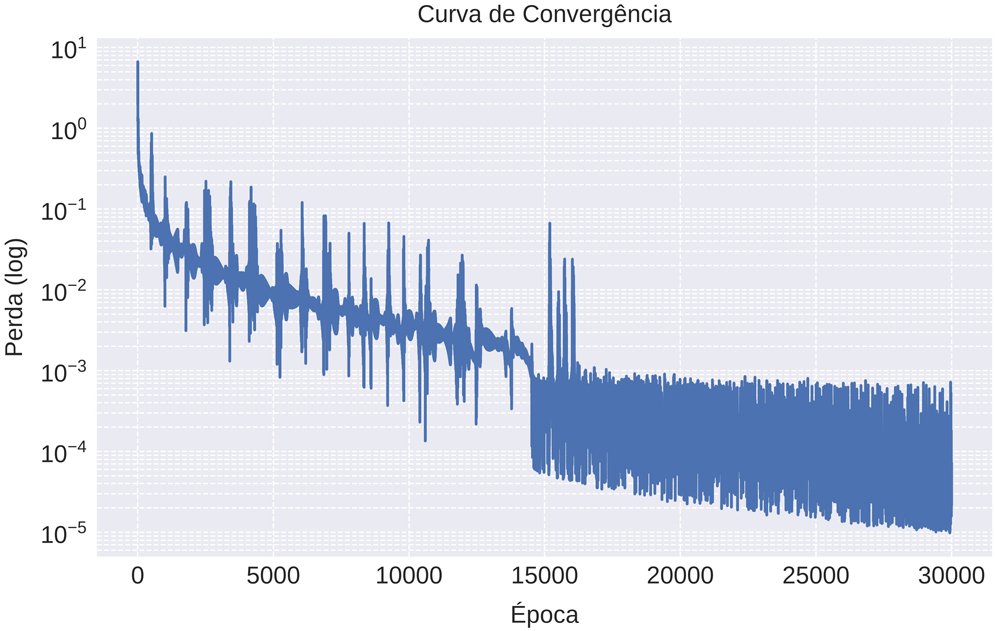
Na Figura 5, mostramos a taxa de perda (“loss_rate”) do modelo treinado. Este é calculado na função “compute_loss” no listing 5 onde temos “loss_bc” para boundary conditions, “loss_center” para o ponto central e “loss_pde” para a equação diferencial parcial em questão. Essa função é chamada no listing 5 para ser otimizada pelo tensorflow.

Na Figura 6, mostramos os resultados convergidos da PINN treinada para o reator cilíndrico para o plano definido por . Note a delineação das bordas no plano em , bem como o formato da superfície em comparação com o resultado exato. Sem o pré-treinamento das condições de contorno, mesmo colocando-se um número muito grande de Épocas para treino, haveria deformações neste locais. A boa convergência pode ser visualizada através do painel que mostra a diferença de valores para um conjunto de pontos pré-determinados. Note que a diferença máxima ficou em torno de 1.18, o que indica uma convergência razoável. Para este ensaio utilizamos cerca de 30000 Épocas. Mostramos também nesta figura a projeção no plano num mapa de superfície para vermos manchas quentes e frias de acordo com as diferenças com relação à solução exata. Vemos que o modelo parece mostrar boa concordância com os valores exatos próximo à região central e um erro um pouco maior nas regiões um pouco mais afastadas do centro, mas com boa concordância nas fronteiras.

Quando normalizamos a equação diferencial do reator cilíndrico vimos que , com e . Dessa forma, poderemos calcular o raio do reator cilíndrico para um , o que implica um cilindro com . Para tanto, se considerarmos um combustível típico de um reator comercial, a base de Urânio, a literatura nos fornece para uma usina de água leve – como um PWR/BWR [5], que é o caso típico de usinas comerciais – o valor de referência para o comprimento de difusão dos nêutrons térmicos na água é de cerca de cm. Essa ordem de grandeza para o comprimento de difusão é corroborada em livros-texto de física de reatores nucleares que listam para água leve cm[19, 20]. Por outro lado, o fator de multiplicação infinito assume valores no intervalo , com valor típico de 1,03[19, 20]. Considerando esses valores e as Eqs.(21), (22) e (28), teremos para o reator cilíndrico em que o raio cm e a altura cm. Há algumas limitações no modelo teórico aqui considerado se compararmos com as dimensões dos reatores reais, pois não incluímos em nossa análise ingredientes obrigatórios nos reatores reais tais como substâncias moderadoras (água pesada ou grafite); não levamos em consideração a heterogeneidade entre as células de combustível; no caso real, o fluxo costuma anular numa fronteira extrapolada, não exatamente na superfície geométrica como aparece na hipótese do nosso modelo. Essas nuances modificariam bastante os resultados obtidos para o tamanho do reator. Por esse motivo, essa situação idealizada é chamada de reator nu uniforme, mas possui elevada importância nas simulações reais para o entendimento do reator como um todo. A simplificação na análise se deve ao caráter pedagógico deste trabalho, ou seja, consideramos até o momento a equação de difusão de nêutrons aplicada a reatores nucleares na sua forma mais simples; assim, uma alternativa seria, além de reconsiderar as limitações mencionadas, utilizarmos, por exemplo, a equação de difusão de nêutrons multigrupos.
6. Considerações Finais e Perspectivas
Neste trabalho foram apresentados de forma pedagógica dois assuntos que despertam bastante interesse da comunidade acadêmica, quais sejam: reatores nucleares e inteligência artificial. Nesse processo, é esperado que o leitor, mesmo o menos familiarizado com tais conteúdos, compreenda a essência da física de nêutrons aplicada ao reator nuclear, bem como os príncipios básicos das redes neurais informadas por física. O material se destaca pela forma pedagógica que é apresentado, isto é, tanto as passagens matemáticas concernentes à equação de difusão de nêutrons, como a discussão acerca das PINNs foram construídas com bastante detalhe, com o objetivo de ser suficientemente inteligível. Nesse bojo, o problema do reator nuclear foi discutido analiticamente para o formato cilíndrico. o qual foi também solucionado com o uso da PINN, e os resultados obtidos por meio de ambos os métodos foram compatíveis. As limitações do modelo utilizado ficaram evidentes quando o tamanho estimado foi comparado com o tamanho real do reator; tendo tais diferenças origem nas hipóteses do aracbouço simplificado. Assim, como perspectiva, apontamos o aprofundamento, com o uso de PINNs, na equação de nêutrons multigrupo, assim seria possível tratarmos situações mais realísticas. Nessa perspectiva, o material apresentado apresenta potencial de ser utilizado por estudantes de graduação em física e engenharia que estejam interessados a iniciar estudos em física de reatores nucleares.
Agradecimento
Os autores agradecem ao Deputado Federal José Airton Félix Cirilo que através da emenda parlamentar No 23310003 tornou possível a rea-lização deste trabalho.
Disponibildade de dados
Todo o conjunto de dados que dá suporte ao presente texto foi publicado no corpo do artigo
Referências
- [1] G.I. Bell e S. Glasstone, Nuclear reactor theory (Van Nostrand Reinhold, New York, 1970).
- [2] J.J. Duderstadt e L.J. Hamilton, Nuclear reactor analysis (John Wiley & Sons, New York, 1976).
- [3] A.F. Henry, Nuclear-reactor analysis (MIT Press, Cambridge, 1975).
- [4] E.E. Lewis, Fundamentals of Nuclear Reactor Physics (Academic Press, San Dieg, 2008).
- [5] J.C. Lee, em: Wiley Encyclopedia of Electrical and Electronics Engineering (Wiley, Hoboken, 2016), 3 ed.
- [6] L. Vlahos, H. Isliker, Y. Kominis e K. Hizanidis, arXiv:0805.0419 (2008).
- [7] W.M. Stacey, Nuclear Reactor Physics (Wiley, New York, 2001).
- [8] J.R. Lamarsh e A.J. Baratta, Introduction to Nuclear Engineering (Prentice Hall, Upper Saddle River, 2001), 3 ed.
- [9] M. Raissi, P. Perdikaris e G.E. Karniadakis, J. Comp. Phys. 378, 686 (2019).
- [10] X. Jin, S. Cai, H. Li e G. Karniadakis, Journal of Computational Physics 426, 109951 (2021).
- [11] H. Jin, M. Mattheakis e P. Protopapas, em: 2022 International Joint Conference on Neural Networks– IJCNN (Piscataway, 2022).
- [12] G. Kissas, Y. Yang, E. Hwang, W.R. Witschey, J.A. Detre e P. Perdikaris, Computer Methods in Applied Mechanics and Engineering 358, 112623 (2020).
- [13] E. Schiassi, M. Florio, B.D. Ganapol, P. Picca e R. Furfaro, Annals of Nuclear Energy 167, 108833 (2022).
- [14] J. Wang, X. Peng, Z. Chen, B. Zhou, Y. Zhou e N. Zhou, Annals of Nuclear Energy 176, 109234 (2022).
- [15] Y. Yang, H. Gong, S. Zhang, Q. Yang, Z. Chen, Q. He e Q. Li, Annals of Nuclear Energy 183, 109656 (2023).
- [16] R.E. Marshak, Journal of Applied Physics 18, 185 (1947).
- [17] G.B. Arfken e H.J. Weber, Mathematical Methods for Physicists (Elsevier, Amsterdam/London, 2005), 6 ed.
- [18] H. Baty, arXiv:2403.00599 (2024).
- [19] J.A. Dejuren e H. Rosenwasser, Journal of Research of the National Bureau of Standards 51, 203 (1953).
- [20] M.M. Bretscher, Proceedings of the Indiana Academy of Science 72, 249 (1962).
Editado por
-
Editor-Chefe:
Marcello Ferreira https://orcid.org/0000-0003-4945-3169